

Nous sommes à l’ère de l’AI. AI a un impact significatif sur tous les domaines de la vie, que ce soit la santé, les affaires, l’aviation, la recherche, le transport, les télécommunications, le réseau d’entreprise ou tout autre domaine. À mesure que l’AI touche la vie quotidienne, de nombreux acteurs sont en concurrence pour atteindre la meilleure version possible.
Exigences de réseautique pour l’infrastructure AI :
Alors que les besoins en AI augmentent, il devient aussi nécessaire d’ajouter plus de centres de données et plus d’infrastructures pour répondre à la demande. L’infrastructure AI nécessite des réseaux à large bande passante, à faible latence et sans perte pour soutenir efficacement les charges de travail exigeantes en GPU et les systèmes AI distribués. L’AI requiert ce qui suit pour fonctionner à pleine efficacité :
- Bande passante et débit : Les charges de travail AI, en particulier pour l’entraînement de grands modèles, exigent des réseaux capables de gérer d’énormes volumes de données sans délai. Une bande passante élevée assure un transfert rapide des données entre les grappes de GPU, le système de stockage et les ressources infonuagiques, évitant la sous-utilisation du matériel coûteux et réduisant le temps d'entraînement.
- Faible latence : Minimiser la latence est aussi essentiel pour les applications AI en temps réel. Une faible latence améliore la communication inter-GPU et permet des mises à jour de modèles plus rapides.
- Connectivité sans perte : Un réseau AI bénéficie d’une connectivité sans perte qui prévient la perte de données et assure l’intégrité de celles-ci. Parmi les protocoles utilisés : Infiniband, ROCE et Ethernet.
Schémas de trafic des grappes GPU :
- Trafic est-ouest (GPU à GPU) : Ce trafic implique la communication entre les GPU, notamment pour l’entraînement distribué.
- Trafic nord-sud (données entrantes/sortantes) : Ce trafic concerne la communication entre le GPU et l’extérieur. Il est essentiel pour le GPU pendant l’entraînement et l’inférence.
- Communication collective (plusieurs-à-plusieurs) : L’entraînement AI utilise souvent des opérations comme « all-reduce » où un GPU échange son gradient avec tous les autres GPU. Ce type de trafic en rafale nécessite une bande passante élevée et est à l’origine de la congestion in-cast, lors de laquelle un fort volume de données arrive simultanément à un seul port.
- Plusieurs-à-peu-vers-plusieurs : Trafic interne à la puce où plusieurs éléments de traitement demandent des données à quelques contrôleurs de mémoire.
Afin de répondre aux trafics nord-sud et est-ouest, il faut envisager de construire l’architecture réseau selon les besoins des GPU modernes. Les grappes AI requièrent un réseau sans perte, à haut débit et à faible latence. De plus, il ne devrait y avoir aucune perte de trafic lors de la congestion. Deux des options les plus pertinentes sont :
- Infiniband : Conçu pour connecter serveurs et stockage dans des grappes fonctionnant à des débits extrêmement élevés, typiquement de 100 Gbps à 400 Gbps, avec une latence minimale. L’Infiniband est coûteux en raison des besoins matériels.
- Ethernet : Un protocole basé sur Ethernet permettant des performances élevées, sans pertes et à large bande passante. L’Ethernet est déjà utilisé dans les centres de données traditionnels et la majorité possède une expertise sur cette technologie. Les technologies 1G, 10G, 40G et 100G sont déjà implantées en centre de données. Cependant, l’introduction du 400G et du 800G a révolutionné le domaine de l’Ethernet.
Adoption du 400G et du 800G :
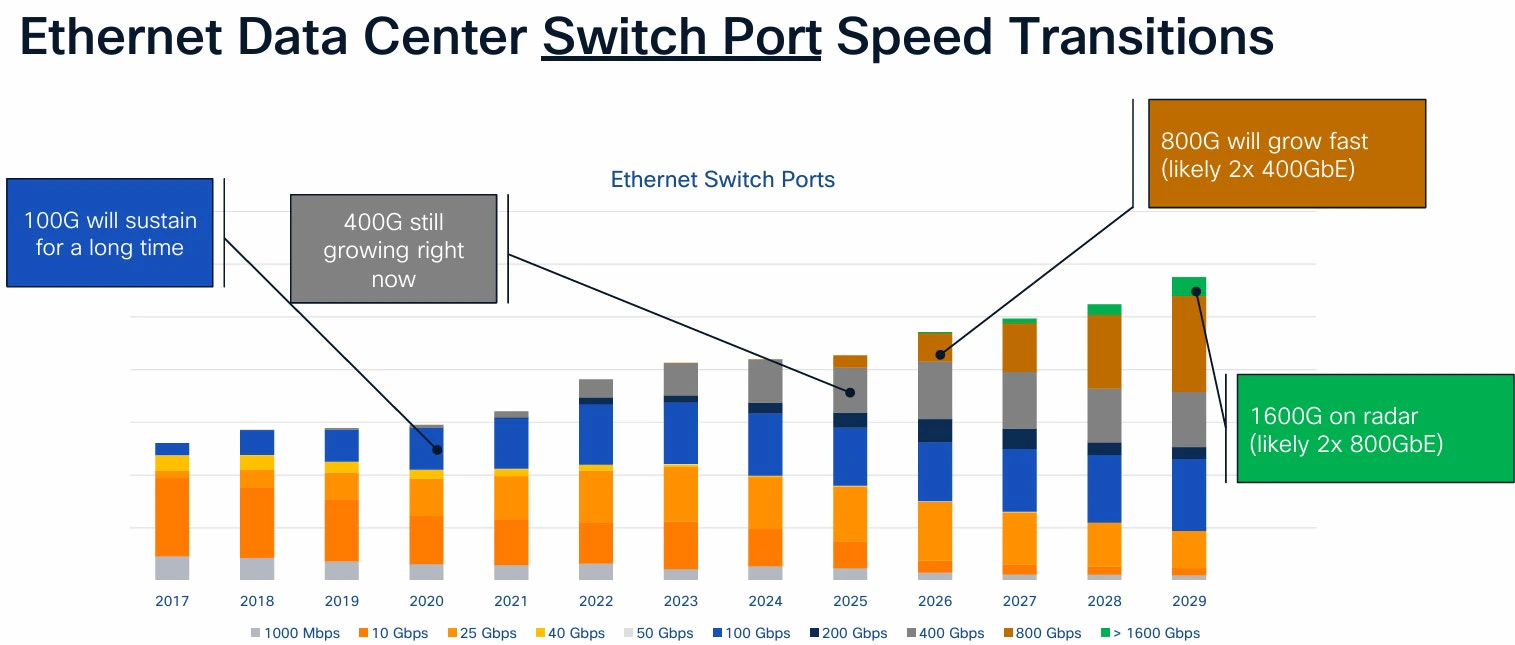
Vous pouvez constater l’augmentation année après année des besoins en vitesse Ethernet, afin de satisfaire les besoins des modules de grappes AI.
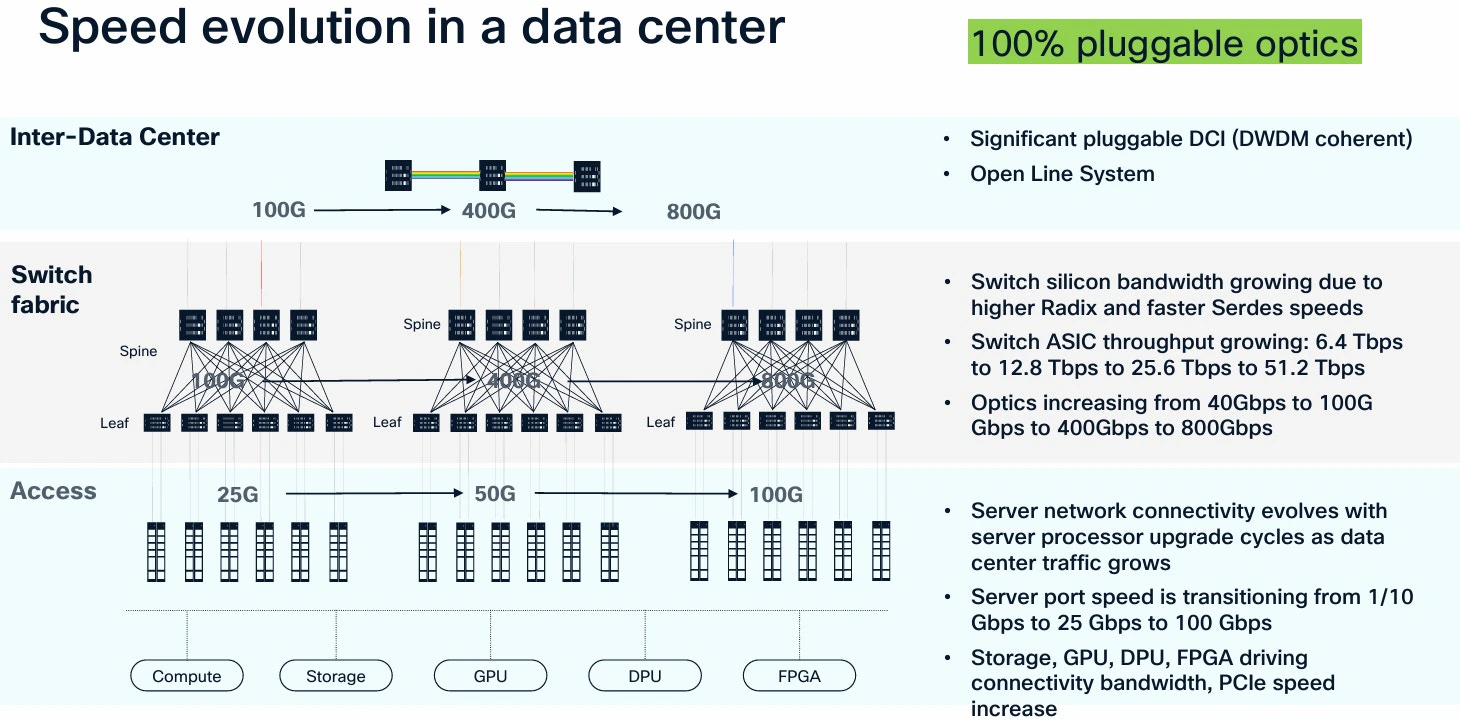
Voici ci-dessous un exemple d’évolution des vitesses en centres de données :
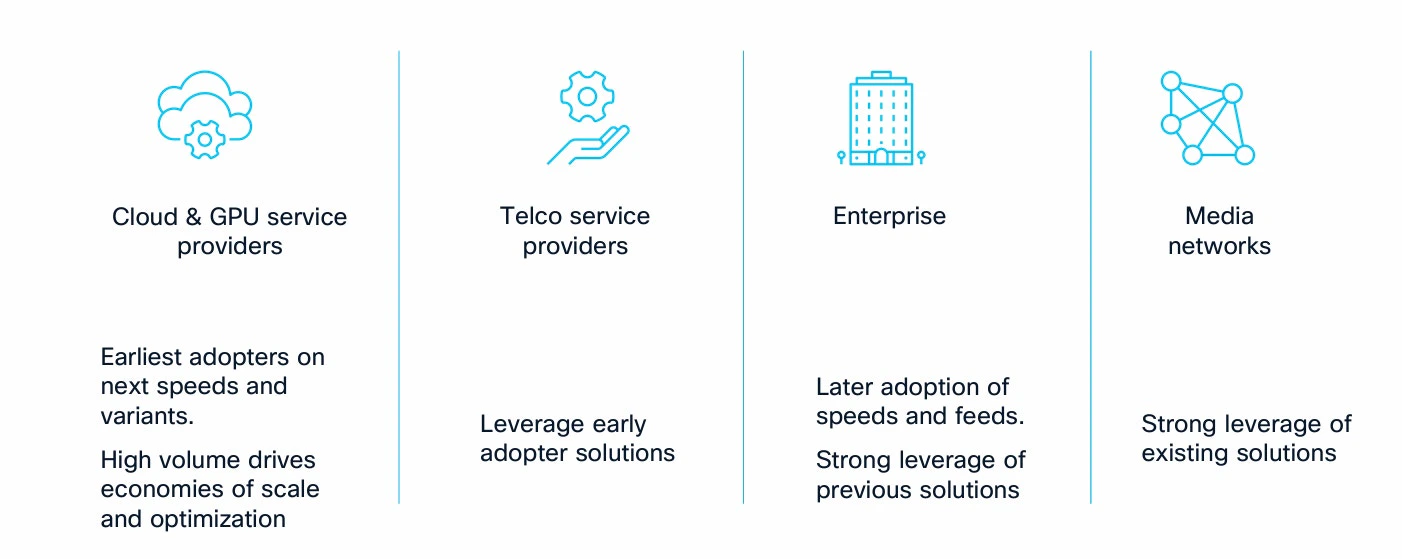
Cas d’utilisation du 400G et du 800G
Architecture « fabric » à déploiement horizontal :
L’architecture « fabric » à déploiement horizontal est un pilier des centres de données de prochaine génération activés par l’AI. En reliant les nœuds de façon horizontale avec un tissu de haute performance, elle surmonte les limites des systèmes à expansion verticale traditionnels, offrant une évolutivité résiliente et rentable pour les applications exigeantes en calcul et en données.
L’architecture en « spine et leaf » est traditionnellement utilisée pour les opérations d’expansion horizontale dans les centres de données actuels. Elle comprend plusieurs commutateurs spine (cœur) et des commutateurs leaf reliant les points d’accès, permettant le routage multipoint et la redondance. L’expansion peut se faire par ajouts progressifs de commutateurs leaf.
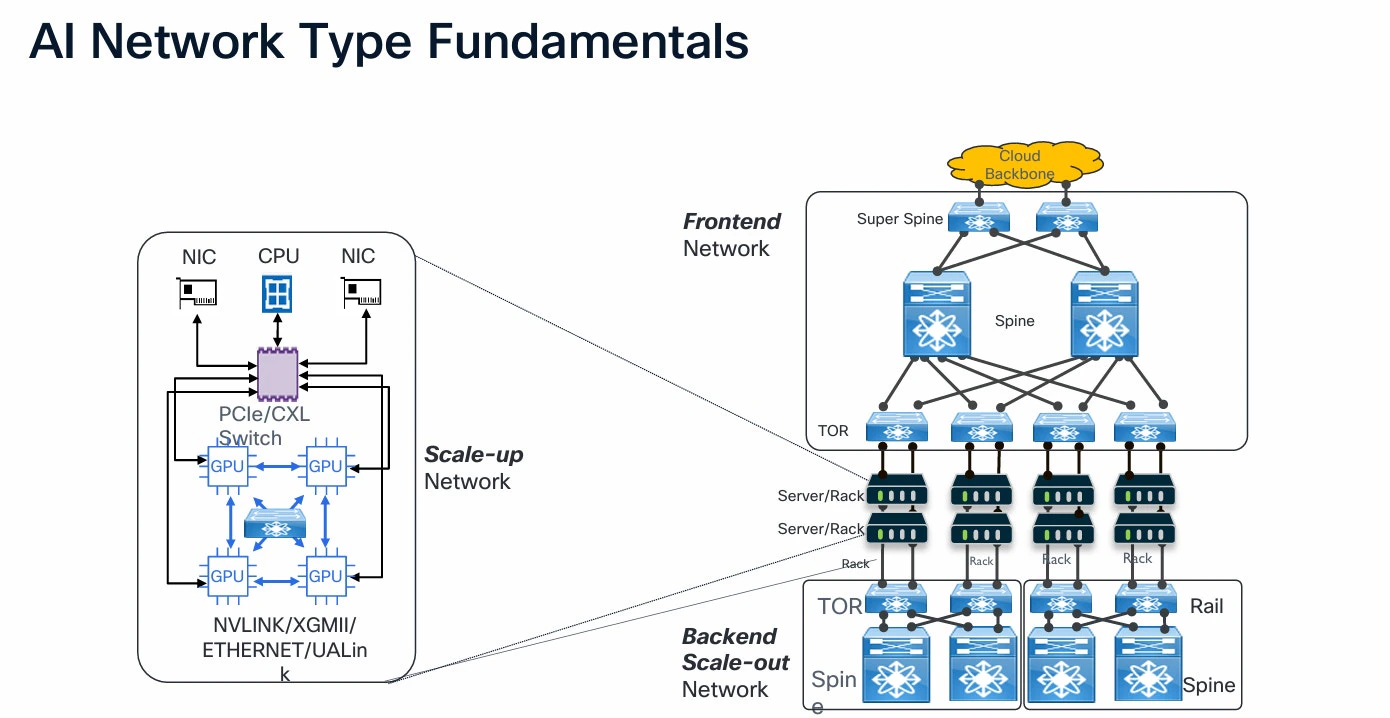
Gestion de la congestion et de la latence : Les grappes AI nécessitent un réseau sans perte et doivent fournir un haut débit. Avec l’utilisation de ports Ethernet 400G et 800G, il est possible de bâtir un réseau à très haut débit. L’Explicit Congestion Notification (ECN) et le Priority Flow Control (PFC) sont utilisés par l’Ethernet pour offrir davantage de contrôle de congestion dans le réseau, assurant une connectivité sans accroc.
Visibilité et télémétrie réseau : La visibilité et la télémétrie réseau sont cruciales pour la gestion et l’optimisation de la performance du réseau, particulièrement avec la demande croissante des charges de travail AI. Avec des ports Ethernet 400G et 800G, les organisations peuvent s’attendre à une bande passante accrue, une latence améliorée, un meilleur contrôle des flux et une efficacité opérationnelle optimisée. En tirant profit des capacités des ports 400G et 800G, l’organisation s’assure que ses réseaux sont capables de répondre aux besoins actuels et futurs pour les charges AI.
Conclusion
L’évolution de l’Ethernet vers le 400G et le 800G a permis la création de centres de données AI évolutifs, à faible latence et à large bande passante. Ces avancées permettent aux organisations d’accroître rapidement leur capacité informatique tout en maintenant efficacité, performance et fiabilité. Avec une architecture adéquate, un contrôle de la congestion et une télémétrie appropriés, les tissus Ethernet de prochaine génération sont parfaitement positionnés pour propulser les écosystèmes AI de demain.

