
Introduction
À mesure que les entreprises passent de l’exploration de GenAI à des applications à grande échelle prêtes pour la production, plusieurs défis apparaissent. Un enjeu majeur est le coût et le temps de réponse des grands modèles de langage (LLM), surtout lorsque plusieurs utilisateurs interagissent simultanément avec l’application GenAI.
Comme tout autre mécanisme de mise en cache, le LLM peut contribuer à répondre à ces préoccupations concernant les applications GenAI. En introduisant et en mettant en œuvre une couche de mise en cache LLM lors des échanges de requête/réponse, la performance de l’application peut être considérablement améliorée. Les accès en cache évitent le traitement basé sur le LLM, et les résultats sont récupérés directement à partir des entrées de cache persistantes, ce qui augmente les performances.
Ce blogue expliquera en détail le fonctionnement de la mise en cache LLM et explorera la conception d’applications GenAI basées sur la génération augmentée par récupération (RAG), avec et sans cache LLM. Il discutera également des considérations de conception uniques et des défis liés à la mise en cache des réponses du modèle linguistique, présentera différentes approches de mise en cache et offrira une étude comparative de la performance applicative avec la mise en cache LLM.
Cache LLM
En informatique, une mémoire cache est un composant matériel ou logiciel qui stocke des données pour accélérer leur récupération lors de requêtes futures. Les données stockées peuvent provenir d’un calcul antérieur ou être une copie d’informations hébergées ailleurs. Un hit de cache survient lorsque les données demandées se trouvent dans le cache, tandis qu’un miss de cache signifie que les données sont indisponibles. Les hits de cache s’effectuent en lisant directement les données du cache, ce qui est plus rapide que de les recalculer ou de les obtenir à partir d’un magasin de données plus lent. Ainsi, plus de requêtes satisfaites par le cache signifient de meilleures performances globales du système.
Le concept de cache LLM suit le même principe de base. Dans le contexte des applications GenAI propulsées par les LLM, les paires requête-réponse servent d’entrées principales pour la mise en œuvre du cache LLM. Le cache LLM est interrogé dès qu’une requête similaire survient. Si une réponse correspondante se trouve dans le cache, elle est renvoyée directement à l’utilisateur, ce qui constitue un hit de cache LLM. À l’inverse, si aucune entrée correspondante n’est trouvée, l’appel LLM génère la réponse, ce qui constitue un miss de cache LLM.
Considérations de conception d’un cache LLM
Entrées de données du cache LLM — La paire requête/réponse générée par les appels LLM est stockée de façon persistante pour servir d’entrées dans le cache. Les requêtes/interrogations peuvent aussi être conservées sous forme d’embeddings vectoriels afin de permettre une recherche sémantique.
Graine du cache LLM — Le mécanisme/processus/planning utilisé pour maintenir le magasin de cache persistant. Idéalement, chaque hit LLM serait stocké dans le cache pour offrir un service de cache à la requête suivante similaire.
Purge du cache LLM — Les entrées du cache peuvent devenir obsolètes en raison de modifications des sources de savoir respectives. Les entrées du cache doivent être rafraîchies selon un calendrier ou par déclenchement dynamique à chaque mise à jour des sources de données sous-jacentes afin d’éviter des réponses obsolètes ou non pertinentes.
Implantation RAG avec cache LLM
Dans la conception d’une application GenAI basée sur RAG, les requêtes des utilisateurs reçoivent une réponse à partir des sources de connaissance vectorisées de l’organisation. Voici comment l’intégration du cache LLM dans une application RAG peut en améliorer les performances globales :
- L’utilisateur interagit avec l’application et soumet une requête spécifique
- La requête de l’utilisateur est convertie en embedding vectoriel, et des techniques de recherche sémantique sont utilisées pour trouver une correspondance pertinente parmi les entrées en cache
- La recherche sémantique est effectuée sur les entrées du cache afin de trouver des réponses correspondantes :
- Si une correspondance proche est trouvée selon le seuil de similarité défini, il s’agit d’un hit de cache et la réponse correspondante est conservée à partir des entrées de cache assorties
- Si aucune correspondance proche n’est trouvée selon le seuil de similarité défini, il s’agit d’un miss de cache et la requête est envoyée pour être récupérée à partir de la couche RAG/LLM sous-jacente
- En cas de hit de cache, la réponse correspondante est envoyée à l’utilisateur (aucun appel LLM n’est requis pour la réponse par hit de cache)
- En cas de miss de cache, lorsqu’aucune donnée similaire ne se trouve dans le cache, la requête de l’utilisateur est transmise à la source de savoir réelle pour en trouver une de similaire
- Les K meilleures données pertinentes sont extraites du magasin de connaissances et, avec la requête originale, sont envoyées au LLM pour générer une réponse
- La réponse finale générée par le LLM est envoyée à l’utilisateur et, simultanément, le cache est mis à jour avec cette réponse afin de faciliter de futurs hits de cache pour des requêtes connexes
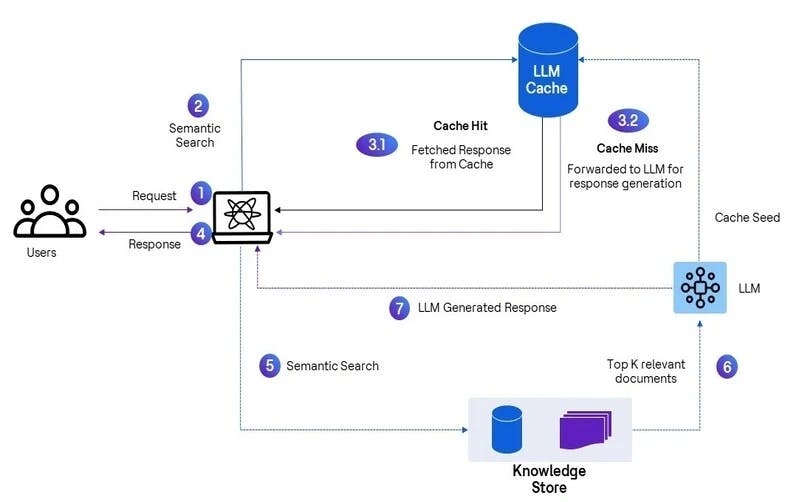
Figure : Implantation RAG avec cache LLM
Comme nous l’avons vu, les hits de cache LLM évitent les appels LLM réels. Voici comment la proportion de hits de cache influence la performance globale de la génération des réponses et le coût des LLM.
Évaluation de la performance
Dans cette expérience, nous avons utilisé ChromaDB en tant que magasin de connaissances (base de données vectorielle) et le modèle Claude v2 d’Anthropic, accessible via Amazon Bedrock, comme grand modèle de langage (LLM) pour générer les réponses. Nous avons mené quatre itérations, chacune composée de dix requêtes, avec différents pourcentages de hits de cache LLM. Les constats de performance sont les suivants :
En faisant varier le pourcentage de hits de cache LLM, nous avons pu mesurer l’impact des réponses en cache sur la performance globale du système. Les observations lors des quatre itérations ont mis en évidence des tendances et des schémas de performance intéressants. Le temps de réponse moyen pour dix requêtes sans cache est d’environ 2,8 secondes, qui diminue linéairement avec des taux de hits de cache plus élevés.
Facteur de durabilité
Les préoccupations grandissent concernant la consommation importante d’énergie et d’eau requise par l’exploitation des grands modèles de langage (LLM), parfois surnommés « géants assoiffés » en raison de leurs énormes besoins en ressources. Cette problématique devient critique alors que l’adoption et l’intégration de LLM continuent de croître dans divers secteurs et applications.
La mise en œuvre du cache LLM est importante pour atténuer ce facteur de risque et favoriser un usage plus durable des LLM. En tirant parti des mécanismes de mise en cache, la récupération et le traitement répétés des informations sont réduits, ce qui diminue l’empreinte énergétique et hydrique globale des systèmes pilotés par LLM.
Conclusion
Intégrer la mise en cache LLM dans les applications d’IA générative permet d’augmenter significativement la performance et de réduire les coûts en évitant les appels coûteux de LLM pour les requêtes répétées. Le cache LLM peut extraire rapidement les réponses pertinentes en stockant les paires requête-réponse et leurs embeddings vectoriels, ce qui accélère le temps de réponse et allège le traitement. Les considérations de conception liées aux entrées de cache, au semis et à la purge sont cruciales pour que le cache LLM demeure efficace et à jour. L’architecture RAG intégrant un cache LLM démontre comment le cache peut s’intégrer harmonieusement, offrant un gain de performance tangible.
À mesure que les organisations développent leurs applications GenAI, l’utilisation d’un cache LLM devient une stratégie clé pour exploiter tout le potentiel des grands modèles de langage tout en relevant les enjeux liés aux coûts et aux temps de réponse.
Pour une compréhension détaillée, une démonstration ou la mise en œuvre de cette solution, veuillez nous contacter : awsecosystembu@hcltech.com.
Références :