Résumé exécutif
logIQ est la capacité d’enquête et de remédiation automatisée de HCLTech, basée sur AWS. Plutôt que d’offrir aux ingénieurs un nouveau tableau de bord à surveiller, il leur fournit un premier intervenant toujours actif. Dès qu’une alerte survient, logIQ commence automatiquement l’enquête et, pour les catégories d’échecs qu’il reconnaît déjà, il résout le problème avant même qu’un ingénieur ne soit contacté.
La conception repose sur une séparation stricte : l’agent qui enquête n’est jamais celui qui agit. Un second agent gère la remédiation et chaque changement qu’il effectue, qu’il s’agisse d’une exécution automatisée en temps réel ou d’une demande de fusion sur un dépôt infrastructure as code, se produit à l’intérieur des contrôles de déploiement déjà en place dans l’entreprise. L’objectif est simple : éliminer les 30 à 90 minutes perdues à chaque incident pour le tri manuel avant que la remédiation puisse commencer.
Introduction
La plupart des processus d’intervention en cas d’incident se ressemblent d’une organisation à l’autre. Une alerte se déclenche, un ingénieur est appelé et, avant toute intervention, l’ingénieur passe la première phase de l’incident à établir ce qui s’est passé : extraire les journaux, vérifier les déploiements récents et cartographier les ressources touchées. Ce travail préliminaire est le prix à payer pour parvenir à la résolution, et il est payé à chaque incident, peu importe le moment.
logIQ est conçu pour combler cette lacune : une plateforme cloud-native, suite agentique qui considère l’enquête et la remédiation comme deux tâches distinctes et automatisables, plutôt qu’un seul travail laissé à un ingénieur. Il fournit un modèle opérationnel pour passer d’une alerte à une résolution documentée sans dépendre de la disponibilité immédiate du personnel.
Le besoin
Considérez ce qui se passe lorsqu’une alerte se déclenche aujourd’hui. Un ingénieur est appelé et la résolution est retardée avant même de commencer, car les journaux sont dans un outil, l’historique des déploiements dans un autre et la topologie des ressources dans un troisième, sans aucune corrélation automatique entre eux. Ce qui devrait être un diagnostic rapide devient une enquête manuelle répétée à chaque incident, peu importe le caractère routinier de la cause sous-jacente.
logIQ comble l’écart entre le déclenchement d’une alerte et l’action. Plutôt que de s’arrêter à la notification, il enquête automatiquement, applique un correctif connu lorsque possible et remet un résumé structuré à un ingénieur uniquement si l’incident exige un jugement humain. Cela permet de garder la réponse aux incidents cohérente, traçable et dans le respect des processus de gestion des changements déjà utilisés par les entreprises : Git et infrastructure as code, et non en dehors de ceux-ci.
Architecture de la solution
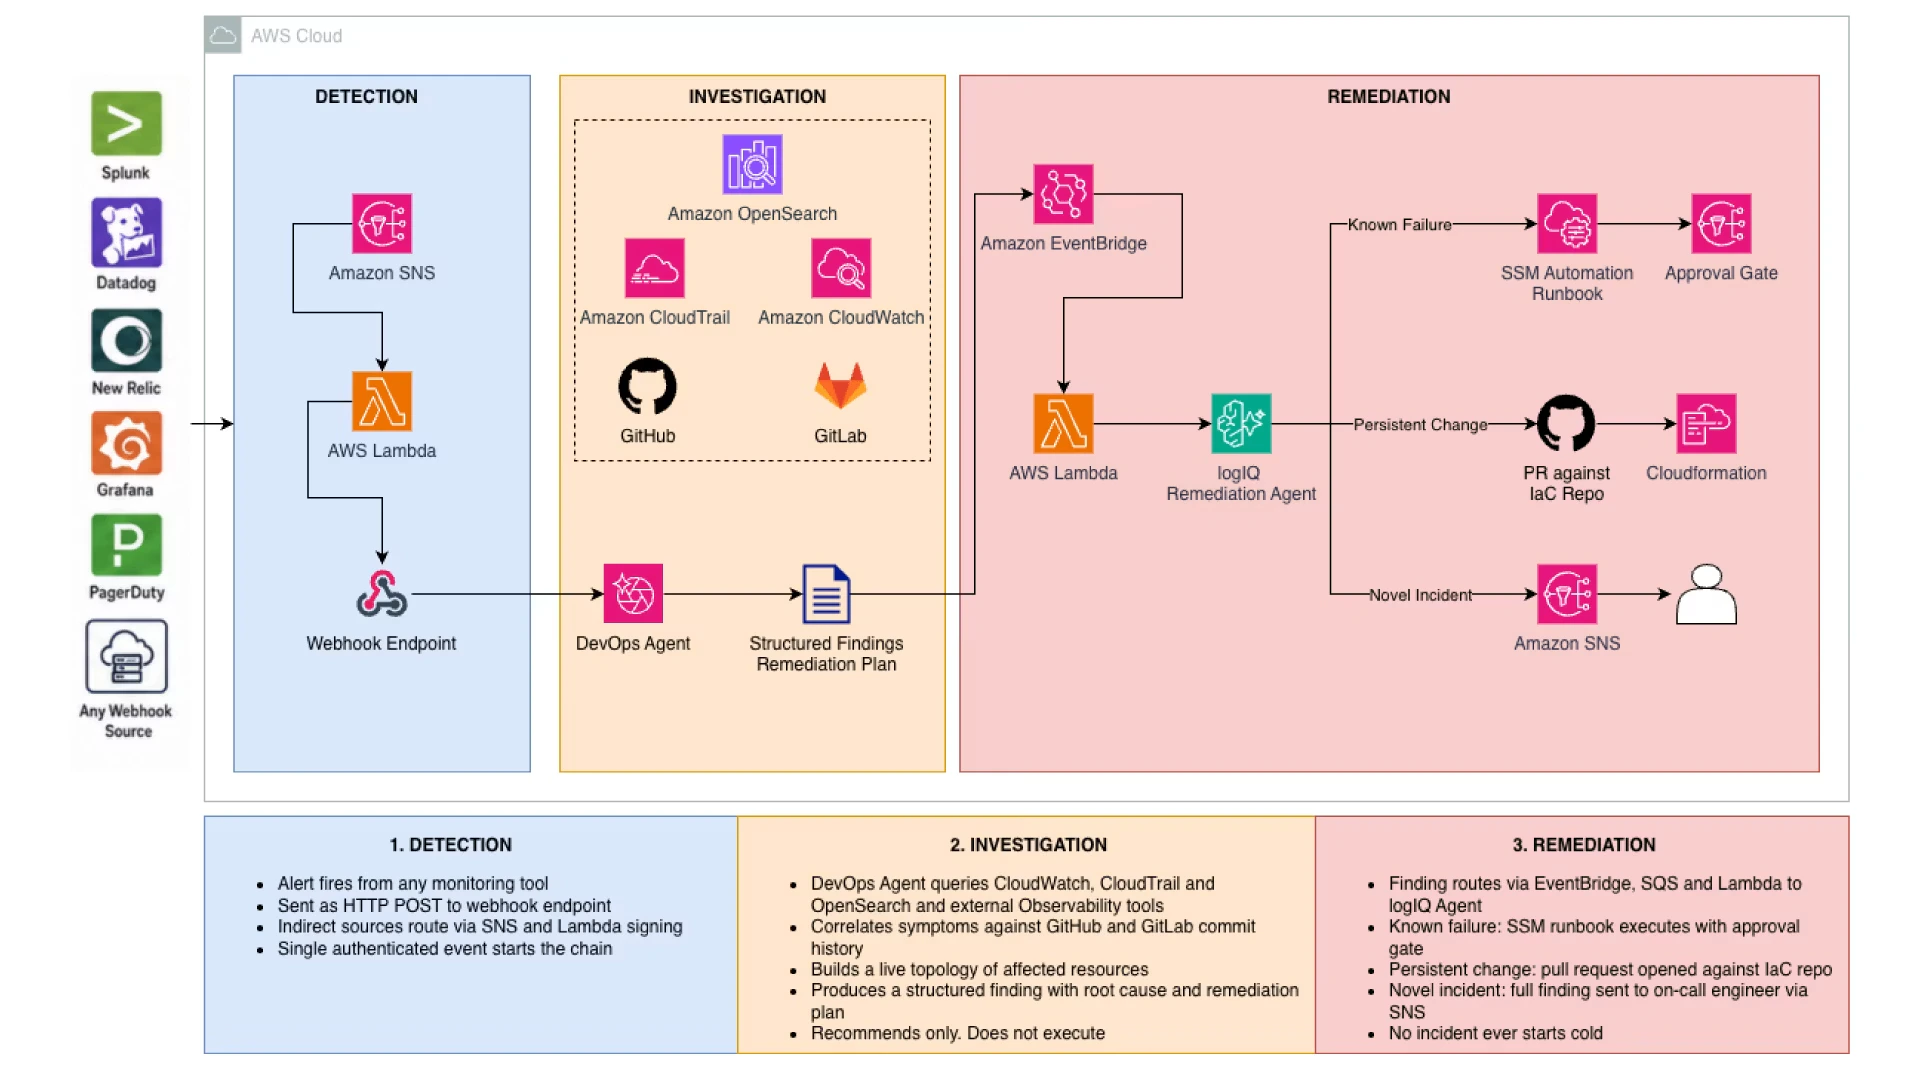
- La plateforme fonctionne en pipeline à trois étapes : Détection, enquête et remédiation. Tout outil de surveillance peut la déclencher ; un agent effectue le travail de diagnostic qu’un ingénieur ferait manuellement et un second agent agit selon les conclusions, sans sortir des contrôles existants.
- Prise en charge universelle des alertes : logIQ accepte les webhooks de toute plateforme de surveillance, notamment Datadog, Splunk, PagerDuty, New Relic, Grafana et ServiceNow. Les sources indirectes passent d’abord par Amazon SNS et une fonction Lambda signée, mais le point d’entrée se comporte de la même façon peu importe l’outil qui a émis l’alerte : un événement authentifié déclenche la chaîne.
- Enquêtes corrélées : Une fois déclenché, AWS DevOps Agent interroge CloudWatch, CloudTrail et OpenSearch, puis vérifie les résultats par rapport à l’historique des commits récents dans GitHub et GitLab. La plupart des défaillances en production sont liées à une modification, de sorte que cette étape de corrélation est en général la voie la plus rapide vers la cause première, en quelques minutes plutôt que les 45 à 90 habituellement requis pour un tri manuel.
- Remédiation via trois voies contrôlées : Dès que l’enquête produit un résultat structuré, l’agent de remédiation logIQ choisit exactement une voie : un playbook SSM Automation pré-rédigé pour les échecs connus, une demande de fusion sur le dépôt infrastructure as code pour les changements à pérenniser, ou un transfert complet à l’ingénieur de garde pour toute situation nouvelle. Il n’existe aucun chemin pour appliquer un changement non validé directement dans un environnement de production.
La couche de raisonnement agentique
La conception repose sur une séparation claire entre l’agent qui enquête et celui qui agit, coordonnée par Amazon EventBridge.
- Enquête : gérée par DevOps Agent. Cet agent a une responsabilité unique : produire une constatation structurée en interrogeant journaux, métriques et topologie en direct, puis en corrélant le début des symptômes avec l’historique des déploiements. Il recommande mais n’exécute pas. Cette frontière permet à cet agent d’agir automatiquement à chaque alerte, sans risque d’intervenir sur une vision incomplète de l’incident.
- Remédiation : gérée par logIQ Remediation Agent. Ce second agent reçoit le résultat via EventBridge et Lambda et son champ d’action est volontairement restreint : échec connu, changement persistant ou incident nouveau. Chaque résultat correspond à une action prédéfinie précise, ce qui garantit une remédiation déterministe et non improvisée.
- Les contrôles de changements ne sont jamais contournés, car les échecs connus passent par SSM Automation derrière une étape d’approbation. Les changements persistants se font via une demande de fusion sur le dépôt IaC, comme CloudFormation, et non par modification directe en production. Dans les deux cas, le processus de validation déjà en place demeure le système officiel pour consigner ce qui a changé et pourquoi. logIQ ne remplace pas ce processus; il fournit l’information nécessaire pour agir plus vite.
Mise en œuvre technique
- Une alerte est déclenchée par tout outil de surveillance, y compris Splunk, Datadog, New Relic, Grafana ou PagerDuty
- L’alerte est livrée comme une requête HTTP POST à un point de terminaison webhook. Les sources indirectes passent d’abord par Amazon SNS et une fonction Lambda de signature, de sorte que chaque événement reçu est authentifié
- Le webhook transfère à DevOps Agent, qui interroge Amazon CloudWatch, AWS CloudTrail et Amazon OpenSearch, ainsi que les outils de surveillance externes connectés tels que Splunk, puis rapproche les symptômes de l’historique des commits dans Git
- DevOps Agent dresse une cartographie en temps réel des ressources concernées et produit un constat structuré avec un plan de remédiation recommandé
- La constatation est acheminée via Amazon EventBridge et Lambda vers logIQ Remediation Agent
- Pour un échec connu, l’agent de remédiation lance un playbook SSM Automation, qui s’exécute derrière une étape d’approbation
- Pour un changement d’infrastructure persistant, l’agent de remédiation ouvre une demande de fusion sur le dépôt IaC, tel que CloudFormation, maintenant ainsi le changement dans les contrôles de déploiement existants
- Pour un incident nouveau, l’agent de remédiation envoie les constatations complètes et le plan recommandé à l’ingénieur de garde via Amazon SNS. Chaque incident, même ceux nécessitant l’intervention humaine, commence avec le contexte plutôt qu’une enquête à l’aveugle.
Architecture technique et services AWS
Services AWS utilisés dans la solution :
- Amazon SNS : Reçoit et transfère les alertes des sources de surveillance indirectes vers la chaîne de détection
- AWS Lambda : Signe les événements webhook entrants et route les constatations structurées de l’enquête vers la remédiation
- AWS DevOps Agent : Effectue des enquêtes automatisées en interrogeant journaux, métriques et topologie, puis corrèle les constats à l’historique des déploiements
- Amazon CloudWatch : Fournit les métriques et la télémétrie opérationnelle utilisées lors de l’enquête
- AWS CloudTrail : Fournit l’audit et l’historique d’activité API servant à identifier les changements récents
- Amazon OpenSearch : Offre une recherche de journaux et une corrélation à travers l’environnement affecté
- GitHub / GitLab (intégrations natives) : Fournissent l’historique des commits et des déploiements nécessaires pour relier les symptômes à un changement précis
- Amazon EventBridge : Acheminement des résultats structurés de l’agent d’enquête vers l’agent de remédiation
- logIQ Remediation Agent : Affecte chaque constat à l’une des trois voies de remédiation contrôlées et exécute la décision
- AWS Systems Manager (SSM) Automation : Exécute les runbooks pré-écrits et validés pour les classes de défaillances connues, derrière une étape d’approbation
- Infrastructure as Code Repository (CloudFormation) : Reçoit les demandes de fusion pour les modifications persistantes de l’infrastructure, maintenant ainsi leur traitement dans les processus d’examen existants
Valeur pour les utilisateurs :
- Cessez de payer la pénalité du triage à chaque incident : Les enquêtes démarrent en quelques secondes après une alerte, corrélant automatiquement journaux, historique des déploiements et état en temps réel des ressources, remplaçant les 45 à 90 minutes typiquement requises pour le tri manuel d’un incident P2
- Résolvez plus rapidement, avec moins de variabilité : Les classes d’échecs connues passent par des runbooks validés, éliminant la variabilité liée à l’ingénieur chargé de l’incident
- Contrôle des changements jamais contourné : Les modifications d’infrastructure persistantes passent par une demande de fusion plutôt qu’une modification directe, donc chaque changement suit encore le processus d’examen déjà établi dans l’organisation
- Séparation claire entre enquête et action : Enquête et remédiation sont effectuées via des rôles distincts, des étapes d’approbation sont intégrées et toutes les actions sont consignées
- Couverture qui s’étend au fil du temps : Lorsqu’un ingénieur résout un incident nouveau, cette résolution devient un runbook potentiel, élargissant progressivement le nombre de classes d’échecs que logIQ peut gérer automatiquement
Appel à l’action : Aucun incident ne devrait jamais commencer sans contexte!
- Évaluez en quelques jours : Un examen rapide des sources d’alerte, de la charge sur les ingénieurs de garde et des types d’incidents récurrents permet de dresser une liste priorisée des situations candidates à l’automatisation
- Pilotez rapidement : Un essai de concept basé sur des scénarios représentatifs issus de votre environnement valide la justesse de l’enquête et la sécurité de la remédiation, avant un déploiement élargi
« De l’alerte à l’action : détecter, enquêter, remédier. »
- Détecter : Acceptez les alertes de tout outil de surveillance par un webhook unique et authentifié
- Enquêter : Corrélez journaux, topologie et historique des déploiements dans un constat structuré, automatiquement, à chaque alerte
- Remédier : Dirigez chaque constat vers une action contrôlée : runbook validé, demande de fusion ou transfert à un ingénieur, sans jamais contourner les contrôles existants avec un changement direct non validé
Les entreprises et les partenaires AWS peuvent contacter HCLTech pour planifier une présentation ou une démonstration de logIQ et découvrir comment une capacité DevOps agentique peut réduire le MTTR sans compromettre la gouvernance
Tags : DevOps, gestion des incidents, AIOps, Agentic AI, AWS DevOps Agent, analyse de la cause première, SSM Automation, infrastructure as code, réduction MTTR, GitOps