

La plupart des discussions sur l’ingénierie de plateforme et les plateformes de développement internes (IDP) commencent par un objectif bien connu : réduire la charge cognitive des développeurs logiciels.
C’est un objectif valide et c’est généralement là que commencent les discussions sur les IDP. Cependant, lorsque nous avons commencé à travailler sur des plateformes de niveau entreprise, nous avons vu un problème différent émerger très rapidement.
La principale friction ne venait pas seulement des développeurs applicatifs, elle concernait aussi les équipes qui devaient construire, maintenir et automatiser l’infrastructure et les plateformes sur lesquelles tout le monde comptait.
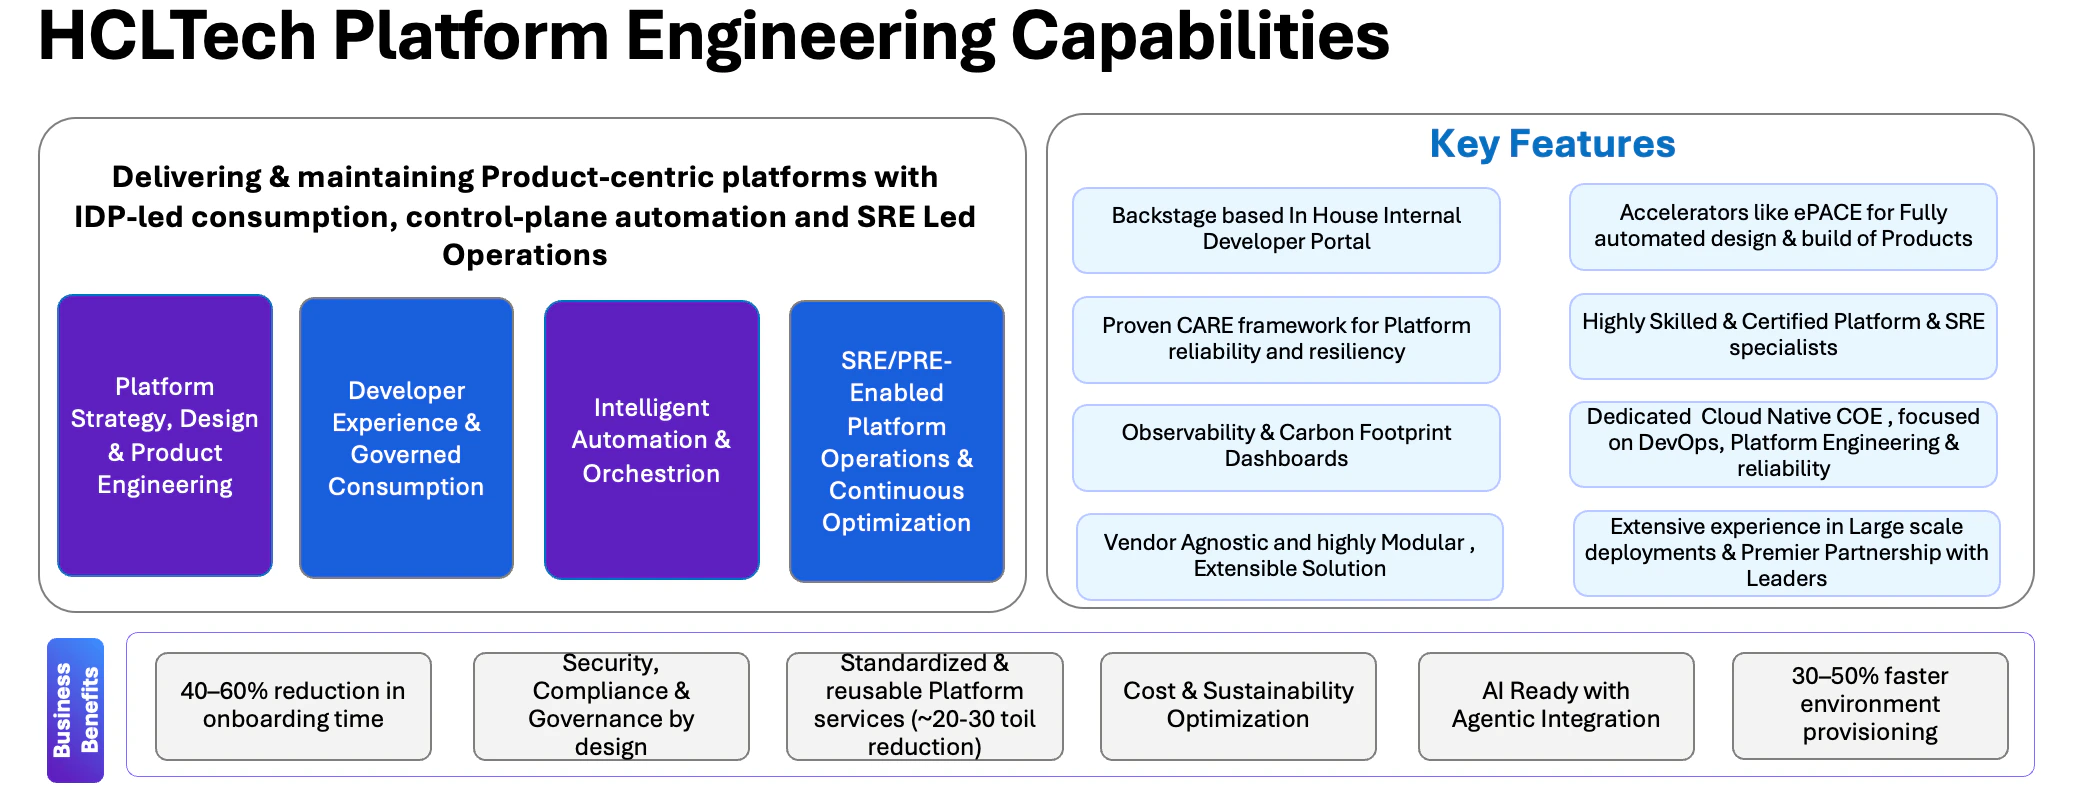
Notre mandat initial était de créer une solution d’ingénierie de plateforme qui inclut les meilleures pratiques, une IDP personnalisable et extensible ainsi que les compétences nécessaires pour tout gérer en un seul endroit. Nous avons réussi à créer tous ces éléments avec un accent majeur sur la productivité des développeurs. En même temps, en allant plus loin dans les défis quotidiens d’exploitation, nous avons opéré un virage délibéré. Nous avons commencé à considérer les ingénieurs en automatisation, les SRE et les opérateurs d’infrastructure comme des utilisateurs de premier plan de la plateforme. Ce changement de perspective nous a permis de concevoir quelque chose de plus utile : non seulement un catalogue, mais un environnement de travail où les équipes plateformes pouvaient créer, tester, gouverner et exploiter l’automatisation de façon plus cohérente. En fait, nous avons reconfiguré toute la solution d’ingénierie de plateforme pour les ingénieurs de plateformes, les ingénieurs en opérations infonuagiques, les SRE, les ingénieurs fiabilité réseau, etc. Maintenant, les mêmes concepts de l’ingénierie de plateforme prévus pour les développeurs logiciels sont utilisés pour les automatisations et les développeurs liés à la GenAI, mais spécifiquement pour l’approvisionnement, les mises à niveau et les opérations automatisées de la plateforme et de l’infrastructure.
Le goulot d’étranglement caché dans les opérations applicatives
Dans de nombreux grands environnements, les opérations applicatives ralentissent parce que l’automatisation des plateformes applicatives et logicielles est dispersée. Nous avons vu des scripts dans différents dépôts, l’infrastructure comme code exécutée depuis des machines individuelles, et les connaissances sur les déploiements applicatifs et plateformes détenues par quelques ingénieurs expérimentés. Rien de tout cela n’était dû à une mauvaise intention. C’était simplement le résultat de plusieurs équipes qui résolvent des problèmes urgents au fil du temps sans modèle opérationnel commun. L’impact devenait visible chaque fois qu’une équipe applicative avait besoin d’un nouvel environnement, d’une mise à jour du pipeline de déploiement ou d’un changement de configuration. La demande se transformait généralement en billet et l’attente commençait.
Ce qui est devenu évident pour nous, c’est que le délai n’était que rarement lié à une question de capacité. Les équipes d’opérations applicatives savaient ce qu’elles faisaient. Le vrai problème, c’est que chaque changement demandait trop d’effort manuel, trop de changement de contexte et trop de validations minutieuses. Si nous voulions améliorer les cycles de déploiement d’applications, il fallait d’abord rehausser le quotidien des ingénieurs qui bâtissent et soutiennent ces pipelines. La solution IDP HCL est devenue le lieu où nous avons coordonné ces flux de travail.
L’introduction de l’ingénierie de plateforme et de l’IDP pour les plateformes s’est révélée salvatrice pour les opérations applicatives. Maintenant, les cycles critiques de déploiement applicatif sont gérés par des automatisations en un clic. Tous les scripts d’automatisation sont conservés dans GitHub et les modèles principaux sont accessibles via l’IDP, ce qui a significativement amélioré la réutilisabilité et réduit les délais de traitement.
Personnaliser Backstage pour la gestion AppOps et plateformes
Notre solution IDP est basée sur backstage, qui se distingue pour cataloguer les services et composantes logicielles. Toutefois, nous avions besoin qu’elle représente les ressources que nos équipes AppOps et plateformes utilisent vraiment tous les jours.
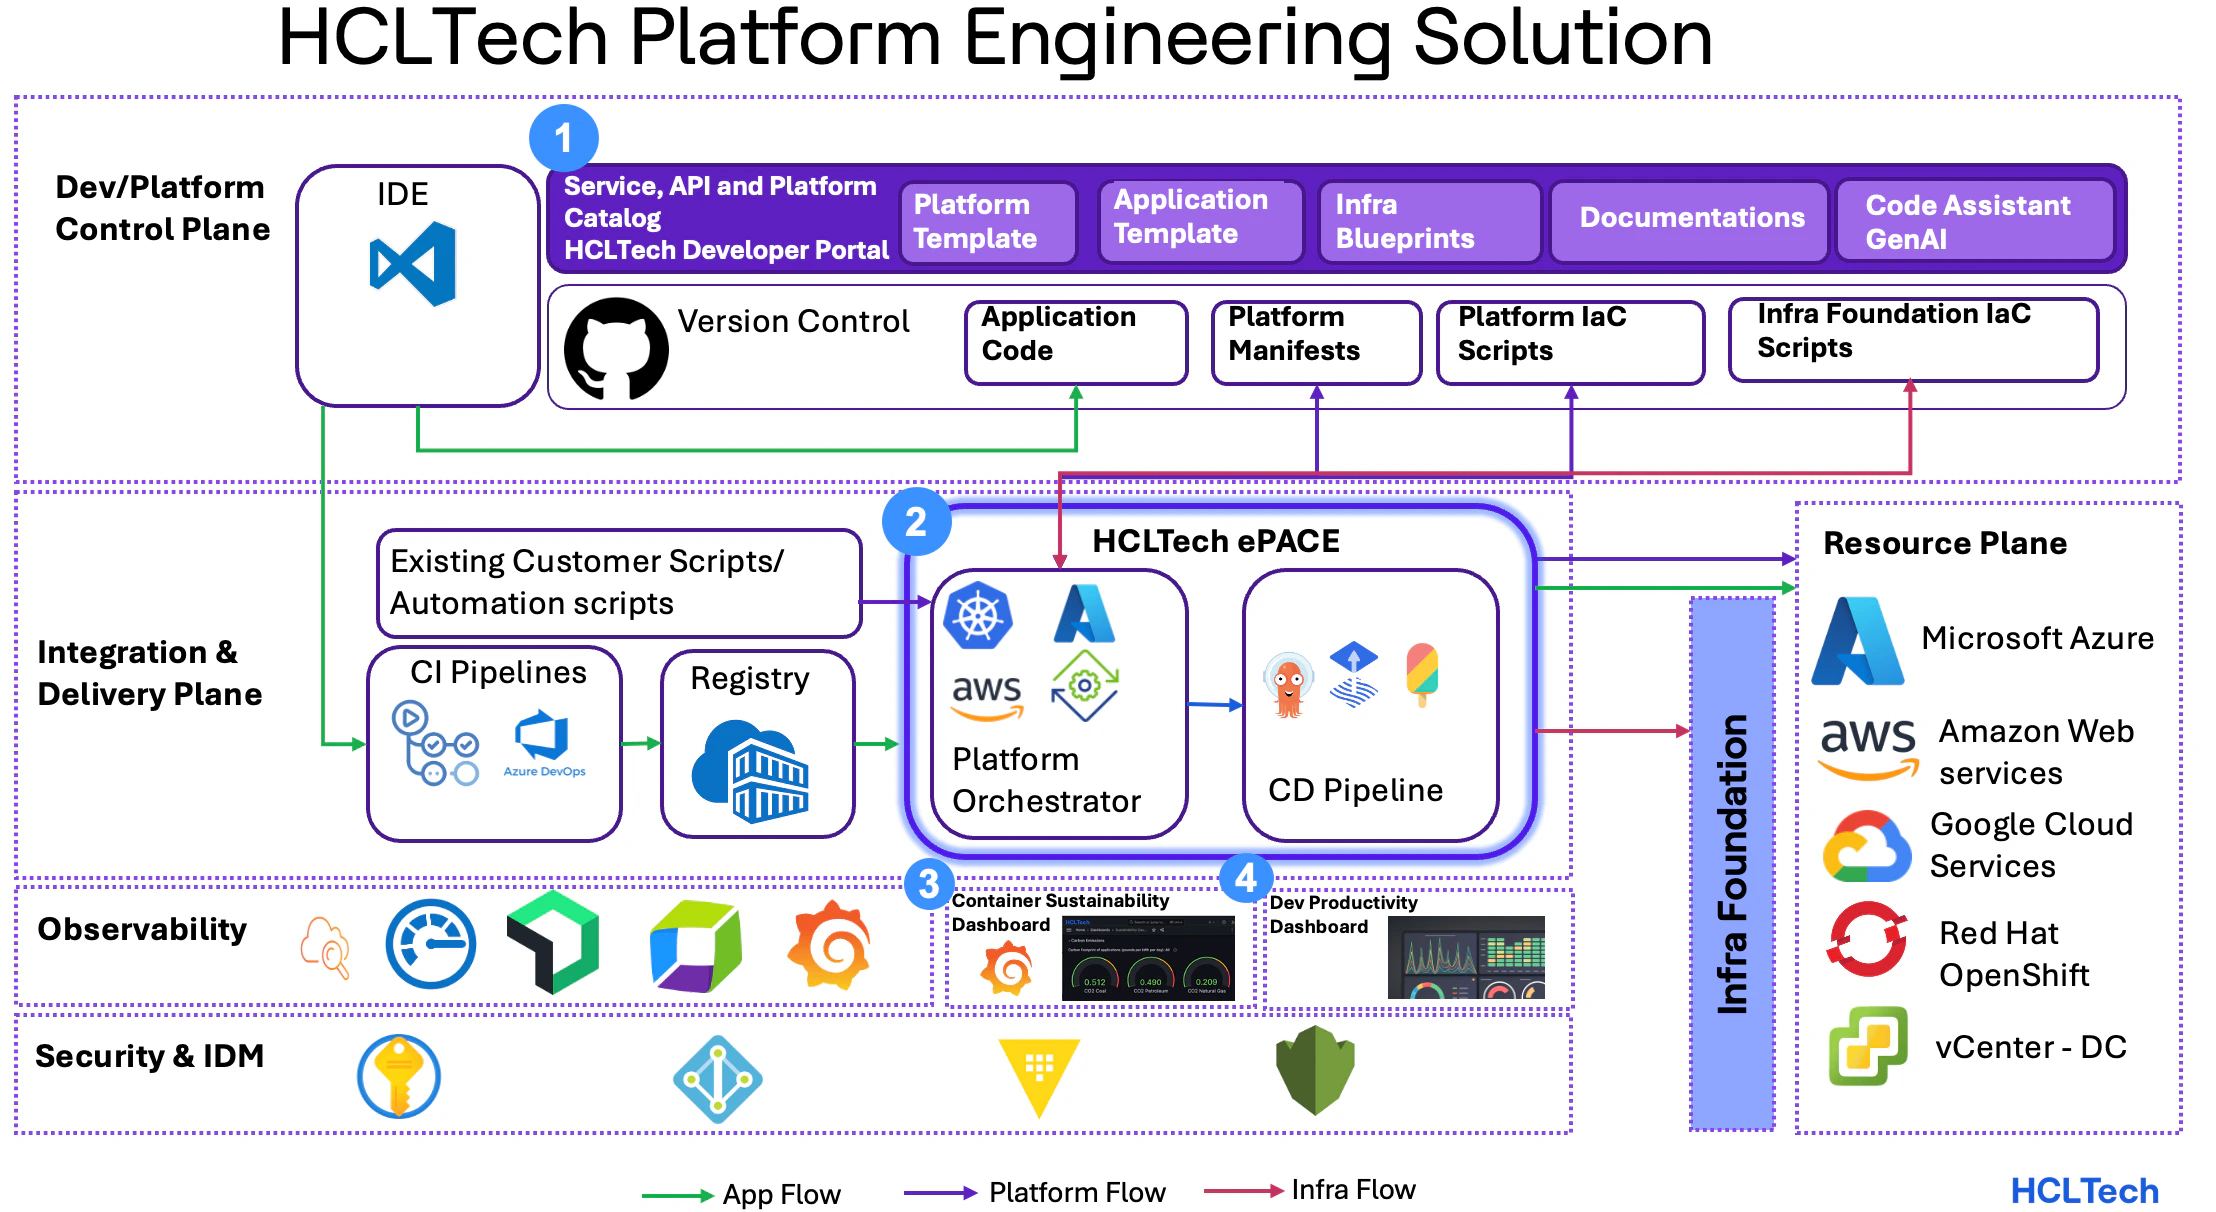
Nous avons élargi le catalogue pour inclure des modules Terraform, des modèles de pipeline CI/CD, des scripts opérationnels, des chartes Helm, des modèles de configuration et des définitions de politiques en tant que code. Cela offrait aux ingénieurs un endroit unique où trouver les ressources d’automatisation approuvées au lieu de fouiller divers dépôts ou de demander la dernière version.
Ce petit changement a modifié l’utilité de la plateforme. Les ingénieurs en automatisation pouvaient voir ce qui existait déjà, comprendre les dépendances, consulter l’historique d’exécution et réutiliser les modèles plus sereinement. Avec le temps, cela a aussi réduit la création de solutions ponctuelles pour des besoins similaires de déploiement ou d’environnement.
IDP HCL : génération de code propulsée par l’AI
La solution HCL IDP, intégrée au cadre CARE, a été fortement bonifiée et de nombreuses fonctionnalités additionnelles ont été ajoutées ces dernières années. Toutes ces nouveautés s’appuient sur la rétroaction client et sur les évolutions techniques récentes.
L’une des ajouts les plus pragmatiques a été un assistant alimenté par l’AI au sein de l’expérience IDP. Nous ne l’avons pas positionné comme un substitut au jugement de l’ingénieur, mais plutôt comme un moyen d’éliminer une partie du travail répétitif lors de la rédaction d’automatisations de plateformes et de code de configuration. Les SRE et AppOps examinaient, ajustaient et validaient encore le résultat, mais le point de départ était bien plus rapide.
L’assistant a été adapté à nos modèles d’architecture internes, nos exigences de sécurité et nos outils privilégiés. Par exemple, lorsqu’un ingénieur avait besoin d’un manifeste Kubernetes, d’un playbook Ansible ou d’une charte Helm pour un scénario de déploiement donné, l’assistant pouvait générer une ébauche conforme à nos normes. Le véritable avantage n’était pas que l’AI écrivait le code, mais bien de permettre aux ingénieurs de passer moins de temps sur le modèle de base et plus de temps à réfléchir à la gestion du risque, des dépendances et des répercussions opérationnelles.
Plans directeurs pour le déploiement rapide de plateformes
Nous avons aussi compris que générer du code d’automatisation ne représentait que la moitié du problème. La question la plus importante demeure : où le tester en toute sécurité? Par le passé, les ingénieurs avaient généralement un accès limité à des environnements de test réalistes et valider un changement d’infrastructure imposait souvent une coordination interéquipes. Cela entraînait des hésitations, surtout pour les changements touchant le réseau, les migrations de bases de données, les politiques de cluster ou les services plateformes partagés.
Pour pallier ce défi, nous avons introduit des plans de déploiement de plateforme dans l’IDP. Il ne s’agissait pas de modèles applicatifs génériques. Ils étaient conçus pour la validation au niveau plateforme et notre solution vedette ePACE a permis de les activer. Un ingénieur pouvait créer un environnement Kubernetes éphémère avec la pile plateforme standard, appliquer un script ou une configuration, observer le comportement puis supprimer l’environnement après test. Tout cela grâce à ePACE opérant en arrière-plan de l’IDP de façon transparente.
Cela a offert aux équipes un moyen plus sécuritaire de faire des essais. Cela n’enlève pas l’importance de la revue ou du contrôle des changements, mais a diminué la crainte de tester des changements d’infrastructure. Les ingénieurs pouvaient valider le comportement dans un environnement beaucoup plus près de la production réelle, sans mettre des charges actives à risque. Le nettoyage automatique a aussi permis d’éviter le problème fréquent d’environnements de test laissés en marche indéfiniment.
Observabilité en temps réel pour la clarté opérationnelle
Un autre enjeu que nous souhaitions régler était la visibilité opérationnelle. En pratique, les ingénieurs devaient souvent naviguer entre l’IDP, des outils de logs, des tableaux de bord de surveillance et des systèmes de pipeline pour vérifier si un changement avait fonctionné comme prévu. Ce changement de contexte ralentissait le dépannage et rendait difficile de faire le lien entre une action de déploiement et son impact opérationnel.
Nous avons intégré les principales vues d’observabilité dans HCL IDP, permettant aux équipes de voir l’utilisation des ressources, la latence, les taux d’erreur et la santé des environnements là même où elles initièrent ou revoient des changements de plateforme. Cela a rendu les revues plus concrètes. Si un nouveau script d’automatisation augmentait la consommation de ressources ou introduisait des erreurs, l’équipe pouvait s’en apercevoir rapidement et réagir dans le bon contexte.
Piloter le GreenOps avec des tableaux de bord durables
À mesure que la plateforme gagnait en maturité, nous avons commencé à regarder au-delà de la rapidité et de la fiabilité. Les coûts et la durabilité faisaient désormais partie des discussions. Nous avons intégré Kepler, l’exportateur efficace à niveau énergétique basé sur Kubernetes, pour donner aux équipes de la visibilité sur les profils de consommation d’énergie à l’échelle des charges de travail. Cela s’est révélé utile, car cela reliait l’efficacité de l’infrastructure à des décisions de conception applicative.
Pour les développeurs, cette visibilité a rendu l’efficacité plus concrète. Au lieu de ne voir que des valeurs CPU et mémoire, ils pouvaient saisir l’impact énergétique de leurs services. Nous avons trouvé cela utile pour faire passer la discussion d’objectifs abstraits de durabilité à des choix techniques précis : dimensionner adéquatement les charges de travail, réduire les traitements en arrière-plan inutiles et améliorer les trajets de code inefficaces.
Transformer le cycle de vie applicatif et plateforme
Avec le recul, la leçon la plus importante fut que l’IDP devient infiniment plus précieux lorsqu’il reflète vraiment le quotidien des équipes qui exploitent la plateforme. En plaçant l’accent sur les ingénieurs en automatisation et les SRE, nous avons raffermi la base sur laquelle s’appuient les équipes applicatives. Les scripts pouvaient être générés plus vite, testés plus sûrement, réutilisés plus souvent et observés dans le contexte approprié.
Le résultat n’a pas été une transformation soudaine provoquée par un portail. Ce fut une amélioration progressive de la gestion des environnements, des déploiements et de l’automatisation de l’infrastructure. Les équipes applicatives en ont tiré profit parce que les équipes plateformes disposaient de meilleurs outils. Les équipes plateformes, elles, bénéficiaient d’un travail plus standardisé et facile à valider. Pour nous, la vraie valeur de repenser l’IDP : la rendre utile à ceux qui font tourner silencieusement le moteur de livraison.

