


Évaluation BLA-Bench de HCLTech sur 782 tâches pour agents de codage
Aperçu Nemotron 3.5 Super VL a obtenu une récompense sur 452 des 782 tâches d’abus de logique métier (57,8 %), contre 359 sur 782 (45,9 %) pour OpenAI o4-mini. Il a aussi enregistré une récompense de détection plus élevée (51,2 % contre 40,7 %) et de remédiation (64,5 % contre 51,2 %).
L’abus de logique métier compte parmi les problèmes les plus complexes à détecter en sécurité applicative. Contrairement aux défauts de sécurité mémoire ou aux chemins évidents d’injection, ces vulnérabilités apparaissent quand le flux de travail prévu, les règles d’autorisation ou les transitions d’état d’une application peuvent être manipulés d’une façon que les développeurs n’avaient pas anticipée.
HCLTech Applied Research a évalué le modèle NVIDIA Nemotron 3.5 Super VL sur BLA-Bench, un banc d’essai interne conçu pour évaluer si des agents de codage peuvent détecter et corriger des vulnérabilités de logique métier dans des projets logiciels réalistes. Dans cette évaluation, la configuration Nemotron a obtenu de meilleures récompenses, en détection comme en remédiation, que la configuration de référence o4-mini.
L’évaluation a placé les deux modèles dans le même harness Deep Agents Code de LangChain avec un profil d’exécution identique. Chaque tâche fournit la classe CWE et une région d’enquête définie. Aucun exemple propre au benchmark, couche de récupération de sécurité ni outil de validation spécialisé n’a été ajouté à l’agent de base.
Les résultats par catégorie et langage étaient étendus : Nemotron a enregistré un taux de récompense plus élevé dans les 10 catégories d’abus de logique métier et dans 16 des 17 cohortes de langages de programmation.
Pourquoi l’abus de logique métier est un test difficile pour les agents de codage IA
Les outils de sécurité applicative traditionnels sont très efficaces pour identifier plusieurs types de vulnérabilités avec des modèles de code ou de flux de données reconnaissables. Les vulnérabilités de logique métier constituent un défi différent.
Considérons une application qui valide correctement chaque requête API individuelle, mais permet d’appeler ces API dans une séquence non prévue. Ou un service qui applique correctement les vérifications d’autorisation, mais expose une transition d’état interne qu’un attaquant pourrait manipuler. Les différentes parties du code peuvent sembler raisonnables isolément. Détecter la vulnérabilité exige de raisonner sur l’intention de l’application et la manière dont un attaquant pourrait enfreindre ces hypothèses.
Pour évaluer ce problème de façon systématique, HCLTech développe BLA-Bench, un banc d’essai interne organisé selon la taxonomie 2025 du projet incubateur OWASP Top 10 for Business Logic Abuse. La version utilisée dans cette évaluation contient 391 défis sélectionnés à partir de dépôts open source réels avec des vulnérabilités divulguées publiquement et corrigées. Les vulnérabilités sélectionnées sont relativement récentes pour limiter le risque de saturation du modèle et couvrent les dix catégories de la taxonomie.
Le banc couvre 17 langages de programmation, y compris C, C++, C#, Java, JavaScript, TypeScript, Python, Go, Rust, Kotlin, Scala, Erlang, Elixir, PHP, Perl, Ruby et Dart.
Chaque défi génère deux tâches évaluées séparément. Pour la détection, l’agent reçoit le dépôt vulnérable, la classe CWE et un périmètre de recherche, puis rédige un rapport de constats. Le vérificateur de détection exige une découverte comportant le bon fichier, la CWE et la plage de lignes acceptée; il rejette aussi les constats non crédités pour la CWE cible et limite le nombre de constats rapportés. Pour la remédiation, l’agent reçoit le fichier et la région vulnérables, puis modifie le dépôt; tous les contrôles statiques requis et les tests comportementaux doivent être réussis. Cela donne 782 tâches à récompense binaire : 391 de détection et 391 de remédiation.
BLA-Bench est volontairement difficile pour un agent de codage généraliste. L’énoncé de tâche identifie la classe CWE et une région d’investigation. Cependant, l’agent de base n’a ni exemples propres au benchmark, ni tutoriel de catégorie Business Logic Abuse, ni couche de récupération de sécurité, ni outil de validation spécialisé. La localisation et la remédiation dépendent donc de la reconstruction de l’invariant vulnérable à partir du dépôt et du comportement vérifié par le validateur de tâche.
Évaluation de Nemotron 3.5 Super VL dans un agent de codage avec BLA-Bench
Pour la comparaison couverte dans ce blogue, nous utilisons le Deep Agents Code original de LangChain avec OpenAI o4-mini comme agent de référence. Nous utilisons OpenAI o4-mini comme référence d’agent à poids fermés, efficace en coût et réputé être d’une taille comparable au modèle Nemotron 3.5 Super VL. L’objectif va au-delà de la sélection de modèles d’agents : il s’agit de construire un agent de codage spécialisé en sécurité et d’en améliorer continuellement la qualité de détection et de remédiation, ainsi que son efficacité opérationnelle.
- Les deux configurations ont exécuté les mêmes 782 identités de tâches : 391 tâches de détection et 391 tâches de remédiation.
- Les deux ont utilisé le code Deep Agents standard de LangChain, sans outils supplémentaires spécialisés en sécurité.
- Les modèles configurés étaient NVIDIA Nemotron-3.5-Super-VL-120B-A12B et OpenAI o4-mini-2025-04-16.
- Les deux ont utilisé Harbor, le cadre d’évaluation d’agent conteneurisé, avec le même adaptateur Deep Agents et le même profil d’exécution.
- Les résultats décrivent donc les systèmes entièrement configurés sur cette cohorte de référence, et non les pondérations de modèles prises isolément.
- Pour plus d’informations sur l’évaluation, consultez les détails ci-dessous.
Récompense globale, de détection et de correction plus élevée avec Nemotron
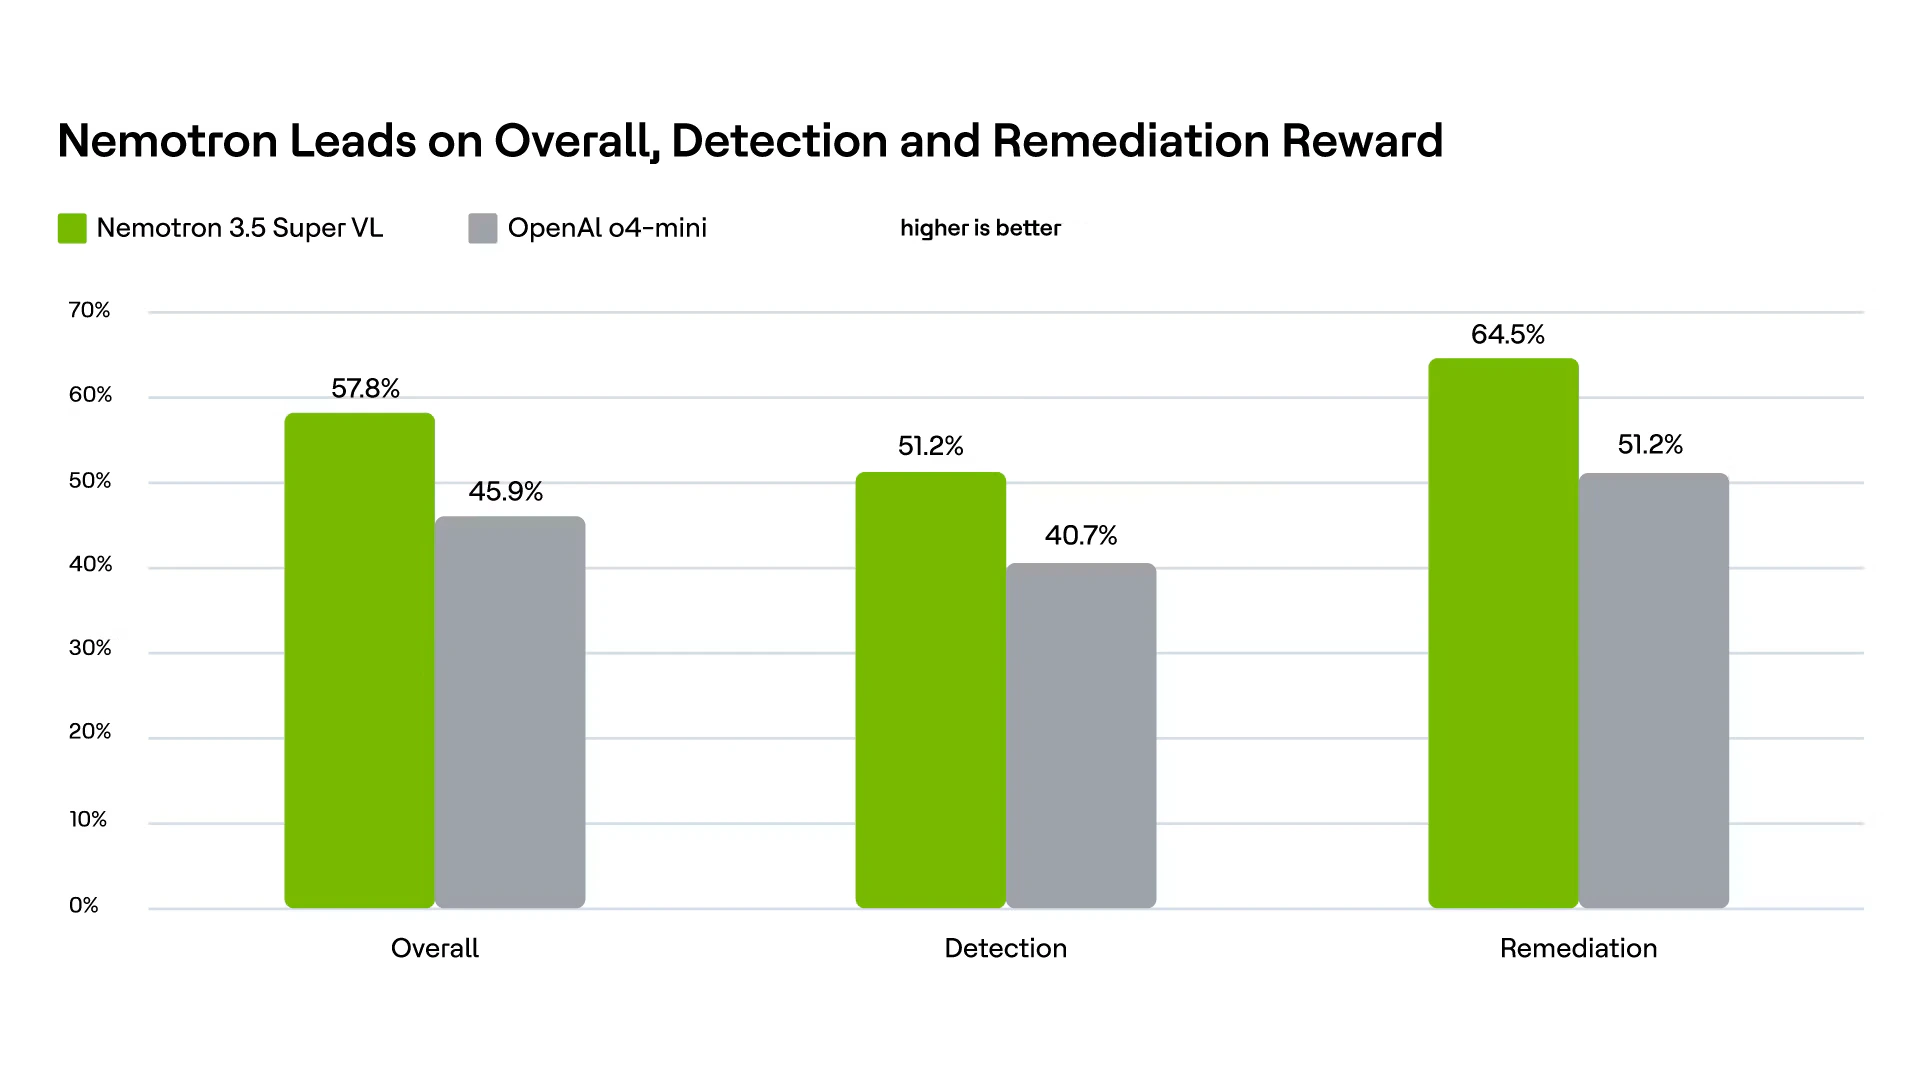
Figure 1. Taux de récompense globale, de détection et de correction observés. Plus c’est élevé, mieux c’est.
Nemotron a obtenu une récompense pour 452 des 782 tâches (57,8 %), contre 359 sur 782 (45,9 %) pour o4-mini, soit une différence de 93 tâches récompensées et de 11,9 points de pourcentage. Comme l’identité des tâches est appariée, l’intervalle de confiance à 95 % pour la différence globale est d’environ 8,4 à 15,3 points de pourcentage.
Les résultats par tâche favorisent Nemotron dans les deux parties du test de référence. Le taux de récompense pour la détection était de 51,2 % (200 sur 391), contre 40,7 % (159 sur 391) pour o4-mini. Le taux de récompense pour la correction était de 64,5 % (252 sur 391), contre 51,2 % (200 sur 391). La différence de correction est de 13,3 points de pourcentage, contre 10,5 pour la détection.
Pour ce résultat de test de référence, la différence représente 41 tâches supplémentaires de détection et 52 de correction ayant obtenu la récompense complète du vérificateur. Pour une équipe de sécurité applicative, cela peut signifier que la configuration Nemotron a permis une localisation exploitable et une correction vérifiable dans plus de cas. À noter qu’il s’agit de résultats de test de référence, et non d’estimations du nombre de vulnérabilités réelles évitées en production, d’heures de triage économisées ou de correctifs acceptés sans révision.
Les diagnostics d’exécution montrent moins de marqueurs d’erreur et moins d’exceptions d’agent
Les résultats d’outils sérialisés montrent des taux de marqueurs d’erreur explicites plus faibles avec Nemotron pour chaque outil standard sélectionné de l’agent de la Figure 2. Les plus grands écarts sont observés pour « execute » (6,6 % contre 21,6 %) et « ls » (0,7 % contre 15,5 %) ; « edit_file » reste l’outil sélectionné le plus problématique pour les deux configurations (40,5 % contre 46,0 %).
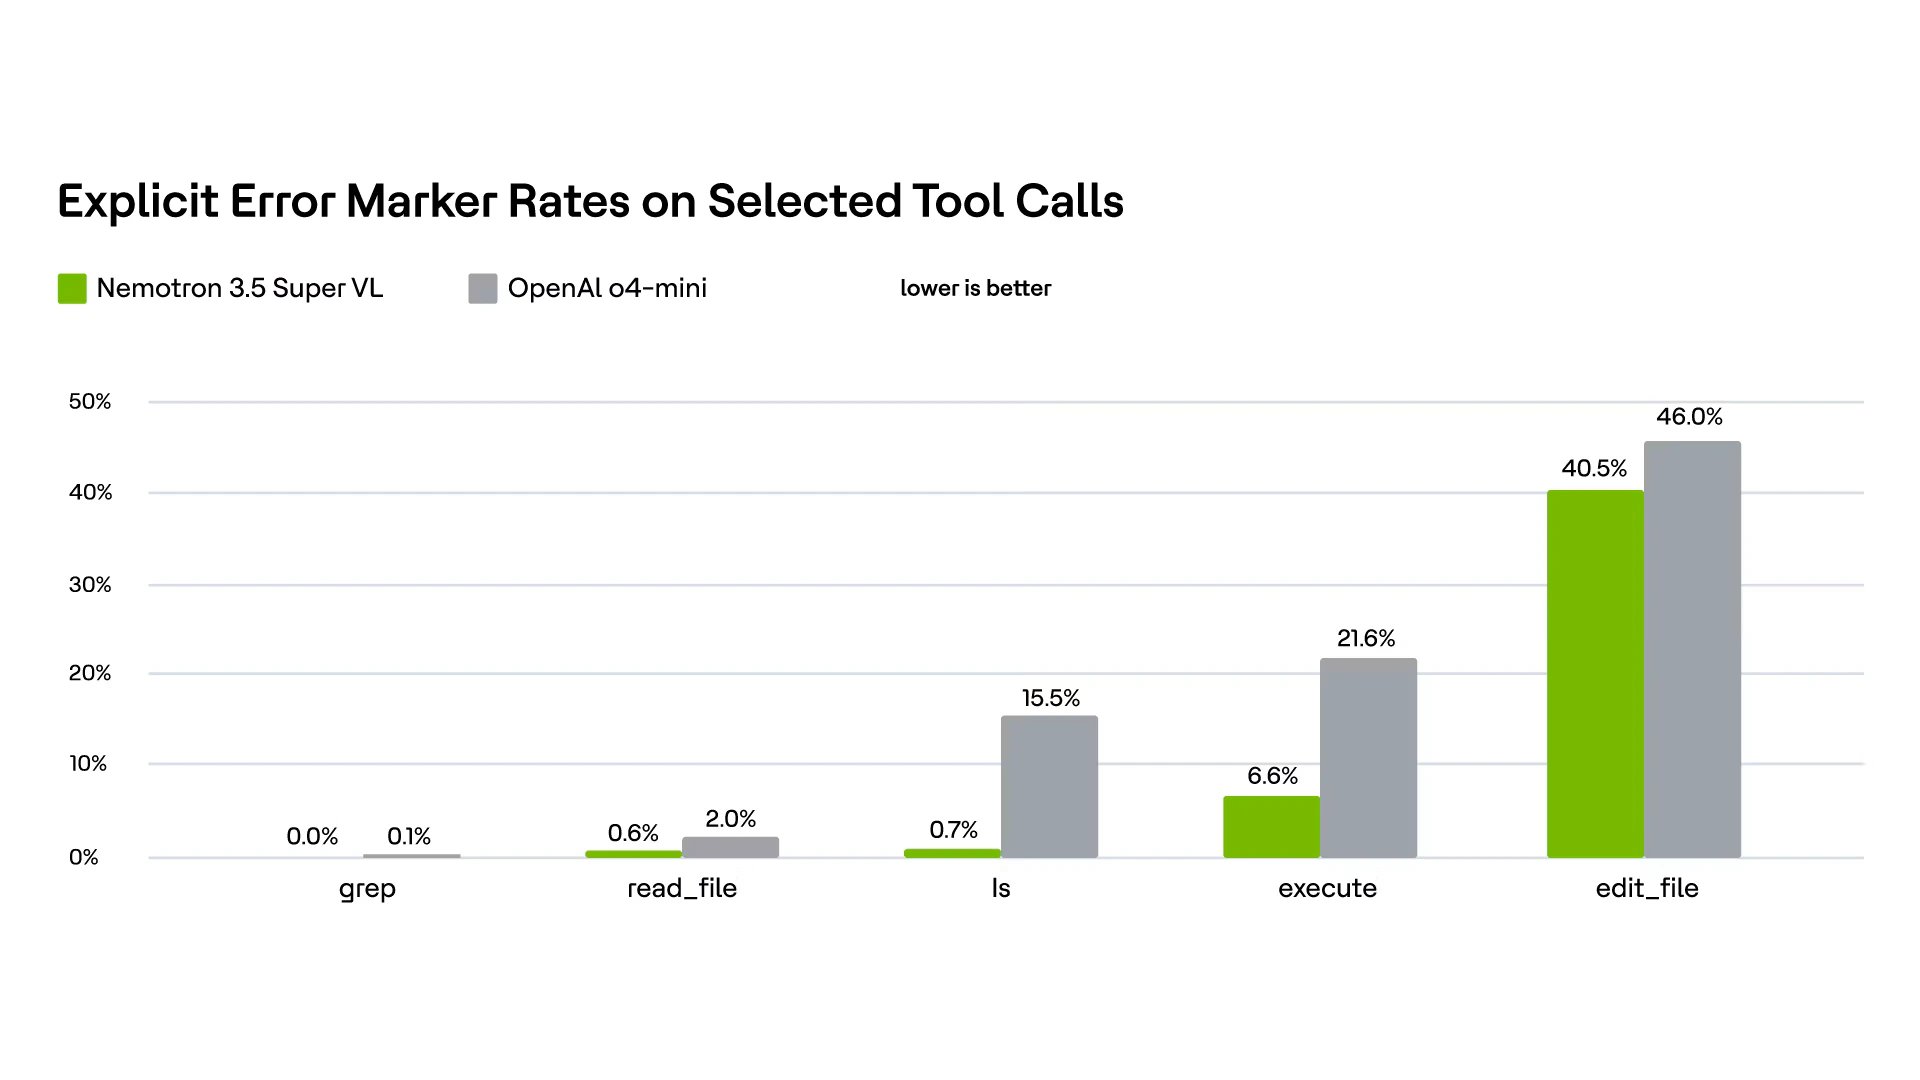
Figure 2. Taux explicite de marqueurs d’erreur pour les résultats d’outils sérialisés sélectionnés, classés par taux Nemotron du plus bas au plus élevé. Un taux plus faible est préférable.
Pour l’ensemble des résultats d’outils sérialisés analysés, 1 191 des 21 278 résultats Nemotron (5,6 %) contenaient un marqueur d’erreur explicite, contre 831 sur 8 015 résultats o4-mini (10,4 %). Les résultats enregistrés ont signalé des exceptions d’agents dans 22 essais Nemotron sur 782 (2,8 %) et 32 essais o4-mini sur 782 (4,1 %).
La performance varie selon les catégories d’abus de la logique métier
Nemotron a affiché un taux de récompense supérieur à o4-mini dans les 10 catégories d’abus de la logique métier. Les plus grands écarts observés concernent BLA6, Validation de transition manquante (67,4 % contre 45,3 %) ; BLA8, Divulgation d’état interne (59,5 % contre 39,2 %) ; et BLA10, Abus de fonction fantôme (60,7 % contre 42,9 %).
Les taux de récompense de catégorie les plus élevés pour Nemotron étaient de 67,4 % pour BLA6 (58 sur 86), 60,7 % pour BLA10 (34 sur 56), 60,5 % pour BLA3 (46 sur 76) et 60,3 % pour BLA5 (41 sur 68).
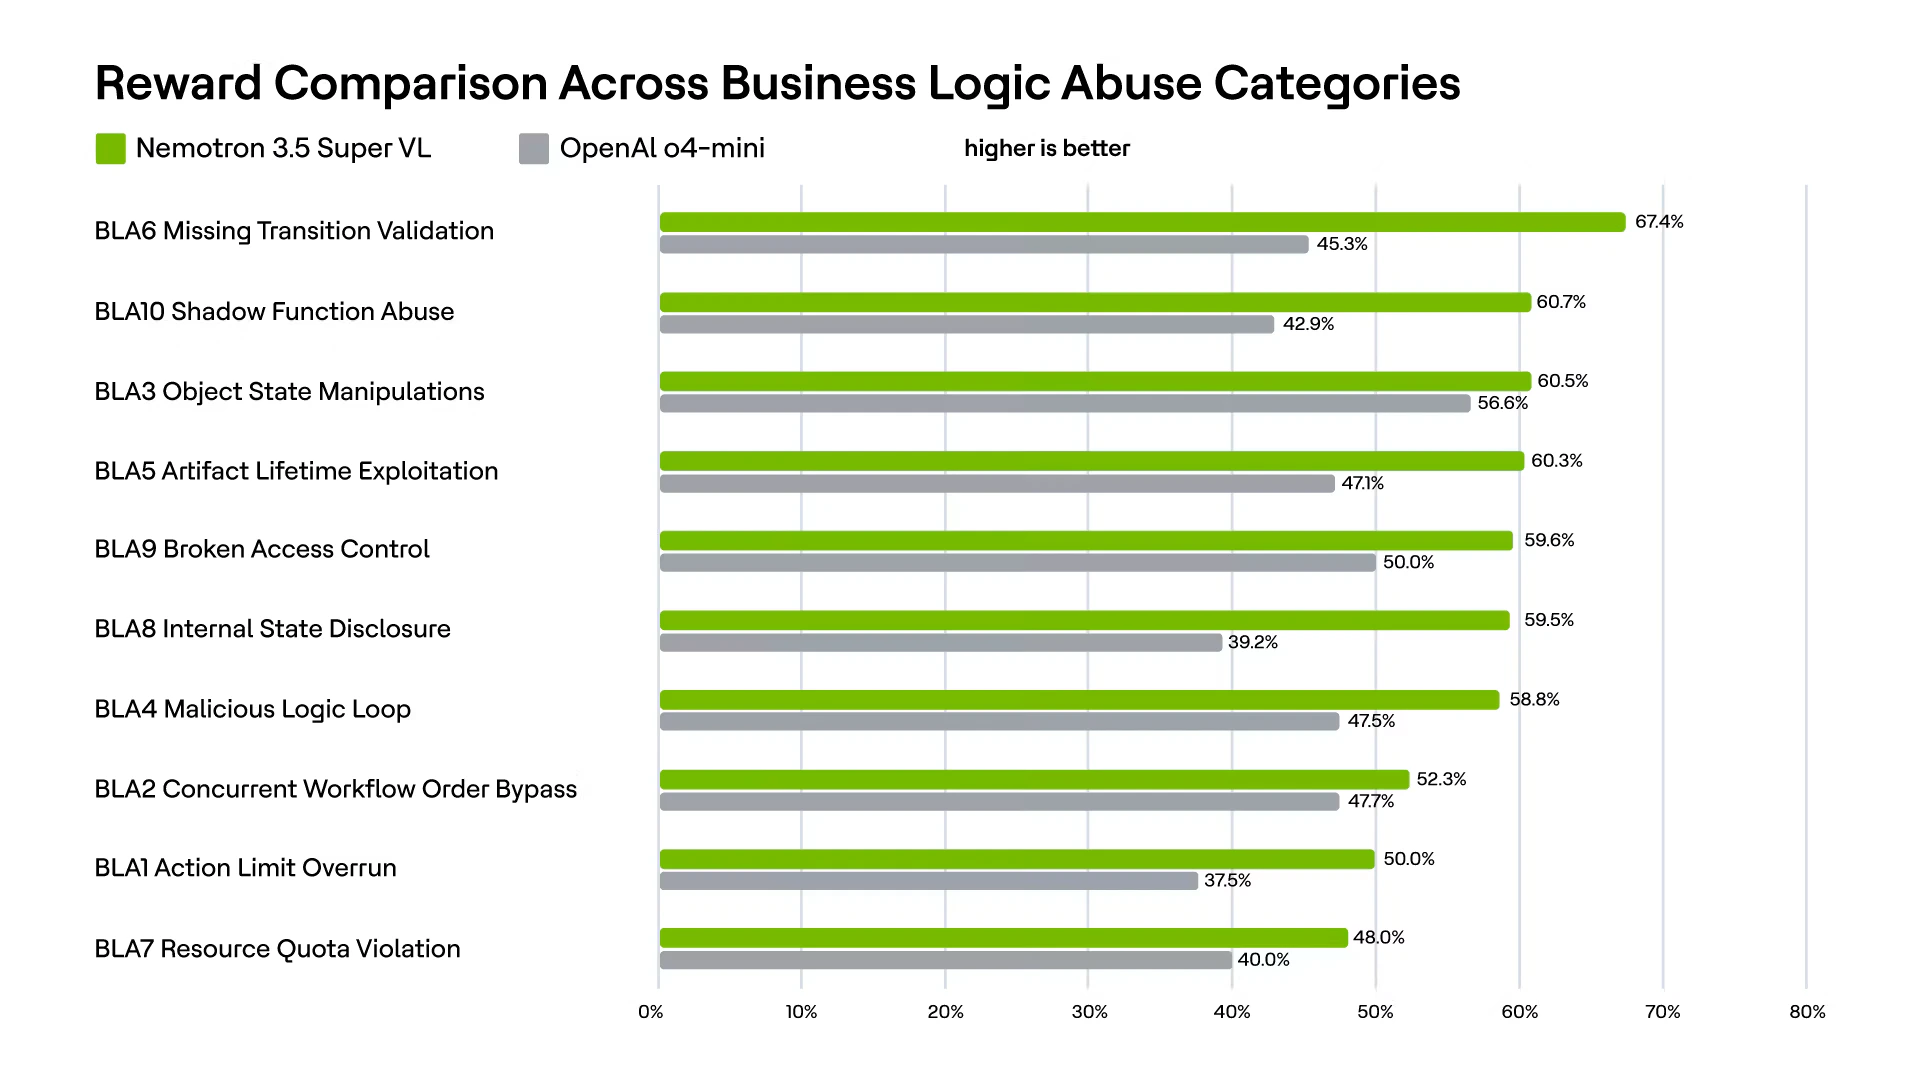
Figure 3. Récompense observée par catégorie d’utilisation abusive de la logique métier pour Nemotron 3.5 Super VL et o4-mini, classées par récompense Nemotron de la plus élevée à la plus faible. Plus c’est élevé, mieux c’est.
Les taux de récompense de catégorie les plus faibles pour Nemotron étaient BLA7, Violation du quota de ressources (48,0 %, 48 sur 100) et BLA1, Dépassement de la limite d’actions (50,0 %, 20 sur 40). Ensemble, elles représentent 140 des 782 tâches, en faisant des cibles concrètes pour une meilleure localisation, une validation guidée par vérificateur et une évaluation spécifique à la catégorie.
Récompense plus élevée dans 16 des 17 langages
Nemotron a devancé dans 16 des 17 langages. Kotlin était à 80,0 % contre 70,0 % (16 sur 20 contre 14 sur 20), un écart de 10,0 points, inférieur à ceux de Scala (25,0), C# (20,8), Rust (20,0) et C++ (16,7). Dart est le seul où o4-mini a mené (80,0 % contre 60,0 % ; 10 tâches).
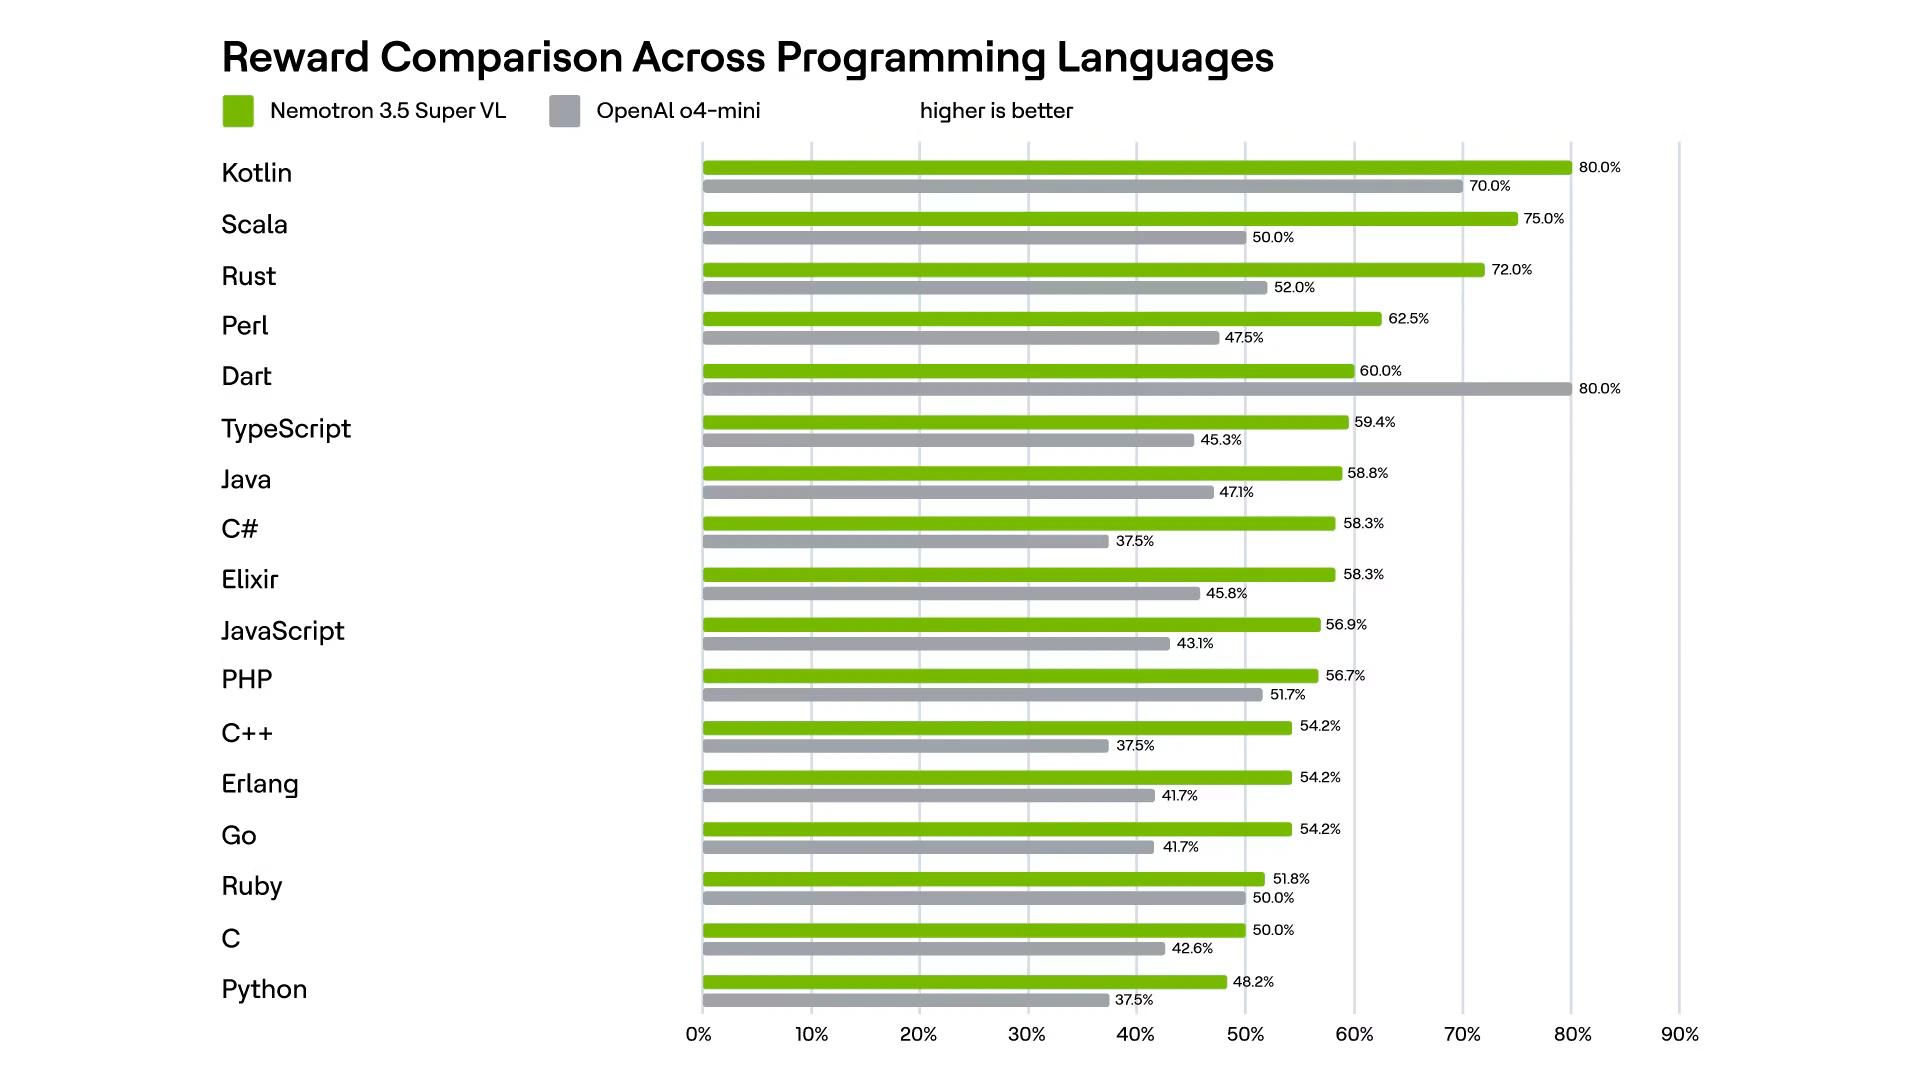
Figure 4. Récompense observée dans les 17 langages de programmation pour Nemotron 3.5 Super VL et o4-mini, classés par récompense Nemotron de la plus élevée à la plus faible. Plus le score est élevé, mieux c’est.
Comment utiliser ce résultat
Utilisez la vue par langage comme carte de couverture et de priorisation. Nemotron a devancé dans 16 des 17 cohortes ; les futurs tests de régression devraient préserver cette ampleur tout en ciblant les segments moins performants.
De l’évaluation de base à un agent de sécurité en amélioration continue
L’évaluation fournit une base pour l’amélioration itérative de l’agent. Sa valeur la plus utile est diagnostique : les segments de catégorie BLA7 et BLA1 demeurent moins performants ; les marqueurs d’erreur explicites sur les résultats d’outils se concentrent sur edit_file et les trajectoires révèlent des occasions de réduire les étapes redondantes et la consommation de jetons. Les deux configurations ont également produit des volumes de résultats d’outils très différents : 21 278 résultats sérialisés pour Nemotron et 8 015 pour o4-mini, soit environ 2,65 fois plus. Cette différence au niveau du système est une cible concrète pour l’optimisation de l’environnement d’agent, du modèle et pour la production de rapports sur les étapes, les jetons et le temps total de traitement en plus de la récompense.
La récompense était plus élevée avec la configuration Nemotron, mais pas l’efficacité. Pour les 782 tâches, les artefacts Harbor rapportent 567,8 millions de jetons d’entrée plus sortie pour Nemotron, et 147,1 millions pour o4-mini. Le temps d’exécution médian de l’agent était de 106,1 secondes contre 62,0 secondes et le temps médian total des essais était de 615,6 secondes contre 311,3 secondes. La comptabilisation des jetons et du cache diffère selon le fournisseur, ces totaux sont donc descriptifs et non une comparaison normalisée de la facturation.
Quelques prochaines étapes pour l’agent :
- Former et évaluer la détection avant la correction, afin que le correctif repose sur un invariant de sécurité bien localisé.
- Utiliser les trajectoires réussies et échouées conservées pour optimiser le choix des outils, la robustesse des modifications, la validation et la terminaison, et pas seulement les réponses finales.
- Améliorer l'efficacité des trajectoires des agents en détectant les cycles répétés de fichiers et d'outils, en exigeant des progrès de validation mesurables et en arrêtant ou en intensifiant le processus lorsque des itérations supplémentaires ne produisent aucune nouvelle preuve.
- Améliorer l'efficacité des jetons grâce à la compaction du contexte, la rétention sélective de l’historique ainsi que des limites sur la répétition des lectures de dépôts et sur les résultats volumineux des outils.
- Renforcer les tranches moins performantes. Prioriser BLA7 et BLA1, améliorer la localisation de la détection et le contrôle des faux positifs, et réévaluer le petit groupe Dart avant de tirer des conclusions spécifiques à la langue.
- Réaliser des ablations contrôlées d'adaptateurs et d'inférences avant les benchmarks complets, incluant les contrôles de raisonnement natifs au modèle, les budgets de raisonnement, les budgets de sortie et autres arguments de génération supportés.
- Réévaluer le même groupe vérifié après chaque modification du modèle ou du support d'agent, puis tester la généralisation sur de nouvelles vulnérabilités mises de côté.
Cette boucle constitue la valeur pratique de BLA-Bench. Elle transforme un problème complexe de sécurité des applications en un programme de développement système mesurable : évaluer, conserver des preuves, diagnostiquer le comportement du modèle et de l’agent, optimiser et vérifier sur des tâches inchangées et mises de côté.
Vers une correction fiable des vulnérabilités par des agents
Sur cette cohorte de 782 tâches de BLA-Bench, la configuration Nemotron a généré une récompense observée supérieure dans l’ensemble et à la fois en détection et en correction. Elle a devancé o4-mini dans les 10 catégories d’abus de logique métier et dans 16 des 17 cohortes linguistiques.
Pour HCLTech et HCLSoftware, ces résultats établissent une base de référence pour de futures évaluations. La voie vers une correction fiable par agents repose sur un modèle et un agent axés sur la sécurité qui progressent ensemble, avec des trajectoires fondées sur des preuves exécutables et chaque optimisation mesurée selon les mêmes résultats de sécurité.
Explorez et essayez NVIDIA Nemotron 3.5 Super VL pour vos propres agents. Pour discuter des agents de codage spécialisés en sécurité et de l’évaluation, contactez HCLTech.
Détails des mesures de référence et de l’évaluation
- Référence : évaluation interne HCLTech BLA-Bench ; 391 cas et 782 tâches par modèle.
- Évaluation des tâches : récompense binaire, 1 seulement lorsque toutes les vérifications du validateur de tâche réussissent, sinon 0.
- Chaque tâche avait une limite de mémoire Docker de 4 Gio.
- Couverture du benchmark : les 10 catégories de la taxonomie incubatrice 2025 OWASP Top 10 for Business Logic Abuse et 17 langages de programmation.
- Conception de l’évaluation : chaque tâche avait une seule tentative notée. La comparaison globale est appariée selon les mêmes 782 identités de tâches.
- Agent : LangChain Deep Agents Code et profil d’exécution correspondant.
- Modèles : NVIDIA Nemotron-3.5-Super-VL-120B-A12B et OpenAI o4-mini-2025-04-16.
- Configurations des modèles : Les deux configurations fixent un délai d’expiration de requête modèle/API de 600 secondes par appel et max_completion_tokens à 16 384.
- Configurations des modèles : Chaque modèle utilisait sa configuration de raisonnement recommandée par le fournisseur. Nemotron : raisonnement activé, reasoning_budget 8 192 jetons, temperature 1,0, top_p 0,95. o4-mini : reasoning_effort moyen, temperature 1,0.
- Interprétation des sous-groupes : Les sous-ensembles par catégorie et langage sont descriptifs et doivent être analysés avec la taille de leur cohorte respective.
- Diagnostics des résultats d’outil : Un marqueur d’erreur explicite est un résultat d’outil sérialisé dont une ligne commence par error, exception, traceback ou failed ; ceci est un diagnostic textuel, et non une mesure de la justesse sémantique ou de la fiabilité en production.
- Preuve : fichiers de configuration Harbor, fichiers result.json par essai, fichiers de résultats d’agent et trajectoires sérialisés et identités exactes des tâches reliés aux métadonnées de tâches BLA-Bench pour les sous-ensembles de catégorie et langage.
