


Résumé exécutif
L’adoption rapide des plateformes Azure Cloud a transformé la façon dont les entreprises conçoivent, déploient et exploitent les bases de données. Alors que l’infrastructure a évolué vers une élasticité, une évolutivité et une automatisation cloud native, les opérations de base de données reposent encore largement sur des processus réactifs, des alertes conditionnelles et une intervention humaine manuelle.
Dans l’environnement numérique actuel, la fiabilité, la performance, la disponibilité et l’optimisation des coûts des bases de données ne sont plus un simple enjeu opérationnel. Elles sont désormais des leviers essentiels à l’activité qui influencent directement l’expérience client, la continuité opérationnelle et l’agilité organisationnelle.
Cependant, les environnements modernes de bases de données Azure font toujours face à une complexité croissante, à la fatigue des alertes, à la prolifération des bases de données, à la hausse de la charge de travail des DBA et à un manque d’intelligence contextuelle. Les plateformes de surveillance traditionnelles identifient les symptômes, mais échouent souvent à expliquer les causes profondes ou à recommander des mesures correctives efficaces.
Pour combler cette lacune, les organisations doivent passer d’une gestion réactive à des opérations intelligentes et autonomes.
Ce blogue présente une solution d’auto-guérison pilotée par l’AI, un cadre opérationnel en boucle fermée conçu pour détecter, diagnostiquer, prédire et corriger de façon continue les problèmes de base de données avec un minimum d’intervention humaine.
En combinant la détection d’anomalie pilotée par l’AI, la récupération de connaissances sémantiques, la remédiation automatisée, l’intelligence prédictive et une gouvernance orientée par des politiques, la solution transforme la gestion de base de données en un modèle opérationnel résilient, autoapprenant et auto-gérant.
Pourquoi les opérations de bases de données doivent-elles évoluer?
L’adoption d’Azure Cloud a accéléré la modernisation des applications et des bases de données en entreprise. Cependant, les pratiques opérationnelles n’ont pas suivi ce rythme.
La plupart des équipes de gestion de bases de données font face aux défis suivants qui affectent la performance organisationnelle et la continuité :
- Modèle d’exploitation réactif : De nombreuses équipes d’opérations de bases de données reposent encore fortement sur les alertes et l’intervention humaine pour identifier et résoudre les problèmes. Par conséquent, ceux-ci sont souvent détectés seulement après avoir eu un impact sur la performance des applications ou sur l’expérience utilisateur, entraînant des délais de réponse plus lents et des efforts de résolution prolongés.
- Fatigue des alertes : Les environnements de bases de données modernes génèrent un grand volume d’alertes, souvent répétitives ou non critiques. Cela provoque de la fatigue au sein des équipes, ce qui complique la distinction entre les incidents critiques et les notifications de routine, tout en augmentant le risque que des problèmes importants soient négligés.
- Complexité opérationnelle : Les environnements Azure deviennent de plus en plus complexes en raison de charges dynamiques, d’architectures multi-locataires et d’exigences de configuration croissantes. Gérer cet écosystème en constante expansion tout en préservant la performance met une pression importante sur les équipes opérationnelles.
- Surcharge des ressources DBA : Les administrateurs de bases de données hautement qualifiés consacrent souvent beaucoup de temps à des tâches répétitives comme la surveillance, le dépannage et la maintenance de routine. Cela réduit le temps disponible pour les initiatives stratégiques, l’optimisation ou la modernisation générant plus de valeur d’affaires.
- Manque d’intelligence contextuelle : Les outils de surveillance traditionnels peuvent signaler qu’un problème existe, mais offrent peu d’explications sur la cause ou la résolution appropriée. Sans intelligence contextuelle, les équipes s’appuient sur l’analyse manuelle et l’expertise individuelle, ce qui augmente l’effort de dépannage et retarde la correction.
Ensemble, ces défis accroissent les risques opérationnels tout en limitant la capacité d’une organisation à profiter pleinement des plateformes de bases de données Azure.
Qu’est-ce qu’une solution d’auto-guérison pilotée par l’AI?
La solution d’auto-guérison pilotée par l’AI est un cadre opérationnel de nouvelle génération qui permet aux bases de données de s’autodétecter, s’autodiagnostiquer, s’autocorriger et d’apprendre en continu des résultats opérationnels.
Contrairement aux solutions traditionnelles de surveillance qui s’arrêtent à la détection, l’auto-guérison établit un système en boucle fermée où chaque phase du cycle opérationnel travaille de concert :
- Détection d’anomalies
- Diagnostic des causes profondes
- Récupération de résolutions éprouvées
- Exécution d’actions correctives
- Validation des résultats
- Apprentissage à partir des résultats
Grâce à ce cycle continu, les opérations de bases de données passent d’une gestion réactive à une résilience proactive et prédictive.
Principales fonctionnalités de la solution d’auto-guérison
Détection intelligente des anomalies
- Détecte les schémas anormaux au-delà des seuils statiques
- Identifie les signaux précoces de dégradation des performances
- Utilise la reconnaissance de schémas pilotée par l’AI
Moteur décisionnel fondé sur la connaissance
- Exploite les incidents passés, les guides opérationnels et les post-mortems
- Identifie des approches de remédiation éprouvées
- Sélectionne les actions selon l’efficacité passée
Remédiation autonome
- Exécute les actions correctives automatiquement
- Prend en charge l’optimisation des requêtes, la mise à l’échelle, la gestion du stockage et le réglage des performances
- Réduit significativement le délai moyen de résolution (MTTR)
Gouvernance basée sur les politiques
- Applique des contrôles opérationnels fondés sur le risque
- Fait respecter les circuits d’approbation nécessaires
- Maintient la conformité et la sécurité opérationnelle
Intelligence prédictive
- Détecte les schémas précurseurs liés à de futurs incidents
- Anticipe les risques en termes de capacité et de performance
- Permet l’évitement d’incidents plutôt que la réaction
Apprentissage continu
- Capte les résultats de chaque cycle de remédiation
- Améliore la précision des recherches au fil du temps
- Renforce la prévisibilité grâce à l’expérience acquise
Architecture de la solution d’auto-guérison
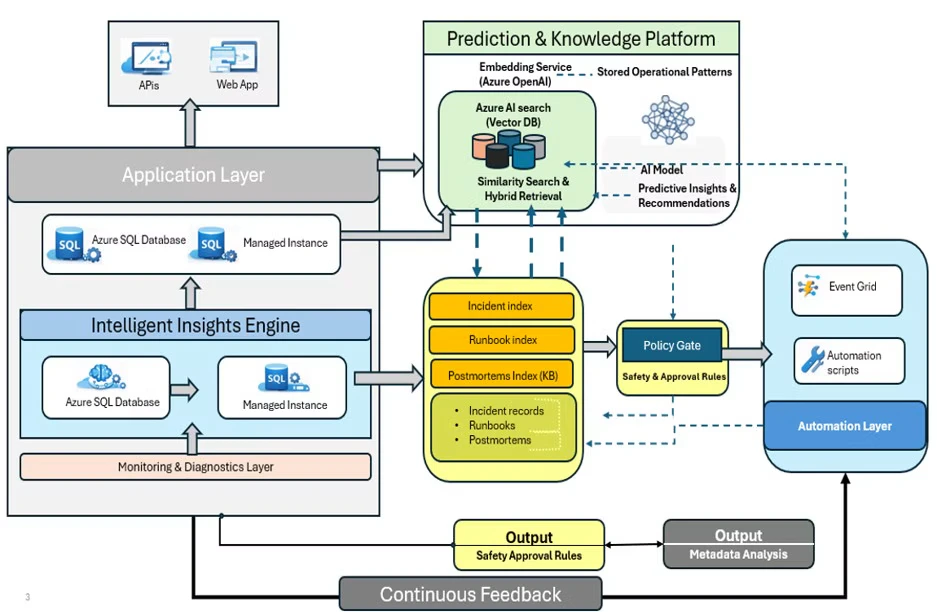
Atteindre l’autonomie opérationnelle pour les bases de données exige plus qu’une simple surveillance ou automatisation. Cela requiert une architecture d’intelligence par couches où la télémétrie opérationnelle est progressivement transformée en compréhension contextuelle, prise de décision gouvernée, exécution automatisée et apprentissage continu.
Chaque couche remplit un rôle distinct tout en contribuant, collectivement, à un système opérationnel en boucle fermée capable de détecter, comprendre, résoudre et prévenir les incidents sur les bases de données à grande échelle.
Couche 1 : Surveillance et diagnostic
La couche de surveillance et de diagnostic procure une visibilité continue sur l’environnement des bases de données en capturant la télémétrie sur les indicateurs de performance, le comportement des requêtes, l’utilisation des ressources et la santé du système. Elle corrèle les données provenant de plusieurs sources (journaux, indicateurs, événements) afin de détecter les anomalies et déclencher des signaux d’incident, assurant ainsi que les écarts sont identifiés tôt avec le contexte diagnostique nécessaire à l’analyse subséquente.
Couche 2 : Analyse et diagnostic
La couche d’analyse et de diagnostic transforme la télémétrie brute en intelligence exploitée en analysant les anomalies détectées grâce à des règles et à des modèles pilotés par l’AI. Elle enrichit les incidents avec des hypothèses sur la cause racine, des évaluations d’impact et une compréhension du contexte, ce qui permet d’identifier le problème précisément. Cette couche fait le lien entre détection et décision en convertissant les signaux en informations exploitables qui guident une remédiation efficace.
Couche 3 : Prédiction et plateforme de connaissances
La plateforme de prédiction et de connaissances agit comme le noyau intelligent du système, exploitant Azure AI Search et les embeddings d’OpenAI pour comprendre sémantiquement les incidents et bâtir une mémoire opérationnelle, alimentée par des banques structurées d’incidents, de guides validés et de résultats post-mortem. Lorsqu’un nouvel incident survient, elle effectue une recherche hybride afin d’identifier les cas passés les plus pertinents et recommande des mesures correctives qui ont démontré leur efficacité dans des situations similaires, pour s’assurer que les décisions s’appuient sur des résultats réels et non des hypothèses théoriques.
Couche 4 : Automatisation et remédiation
La couche d’automatisation et de remédiation traduit l’intelligence en action en orchestrant les correctifs approuvés par politique via Azure Functions, puis en les exécutant avec des guides prévalidés PowerShell ou Python. Elle offre une vaste gamme d’interventions opérationnelles (optimisation de requêtes, mise à l’échelle, gestion des sessions, maintenance), chaque action étant paramétrée dynamiquement pour s’adapter au contexte spécifique, assurant ainsi précision, minimisation du risque et évitant les mesures uniformes ou inappropriées.
Couche 5 : Portail de politiques
Le portail de politiques introduit la gouvernance et le contrôle en appliquant un modèle d’exécution basé sur le risque, qui détermine l’application des actions selon chaque scénario. Les actions à faible risque peuvent être exécutées de façon autonome, celles à risque moyen procèdent avec notification, tandis que les changements à haut risque exigent une approbation explicite. Toutes les activités sont consignées afin d’assurer une piste d’audit complète. Cette couche garantit que l’automatisation respecte la conformité et la confiance à l’échelle de l’entreprise, sans compromettre la rapidité opérationnelle.
Couche 6 : Boucle d’optimisation continue
La boucle d’optimisation continue permet au système d’évoluer vers une plateforme autoapprenante en capturant en continu l’efficacité de chaque remédiation et en réinjectant ces apprentissages dans sa base de connaissances. Progressivement, elle affine le classement des guides, accroît la précision de détection et renforce la capacité prédictive, amenant le système à passer d’une résolution réactive à une gestion proactive et prédictive basée sur l’apprentissage collectif de tous les incidents passés.
Comment la solution d’auto-guérison surmonte les défis majeurs de la gestion de bases de données
- Opérations réactives : L’auto-guérison pilotée par l’AI permet une détection d’anomalies en temps réel et une remédiation instantanée, éliminant les délais liés à l’intervention manuelle et réduisant fortement le MTTR.
- Fatigue des alertes : Le filtrage piloté par l’AI et l’intelligence contextuelle font remonter uniquement les incidents prioritaires et exploitables, réduisant le bruit opérationnel et améliorant la concentration.
- Charge de travail élevée des DBA : Les activités récurrentes comme le réglage, l’évolutivité, le dépannage et l’ajustement de performance sont automatisées via des guides intelligents, permettant aux DBA de se consacrer à des initiatives à plus forte valeur ajoutée.
- Complexité opérationnelle : L’intelligence centralisée et la visibilité unifiée simplifient les opérations dans les environnements distribués Azure.
- Déviation opérationnelle : La surveillance continue et les mécanismes de rétroaction identifient et corrigent automatiquement les écarts par rapport aux normes de performance attendues.
- Coûts et utilisation : L’optimisation pilotée par l’AI permet une utilisation efficiente des ressources, minimisant la surallocation tout en maintenant les objectifs de performance.
- Manque de visibilité sur la cause racine : Les incidents historiques, les guides validés et les analyses post-mortem facilitent l’identification précise des causes et la recommandation de mesures correctives éprouvées.
- Résolution d’incidents retardée : L’orchestration automatisée de la correction accélère l’exécution des mesures, améliore la disponibilité et réduit les interruptions.
- Performance incohérente : L’analytique prédictive identifie les tendances de dégradation avant qu’elles n’affectent les services, permettant des interventions proactives et une optimisation des charges de travail.
- Risques de sécurité et de gouvernance : Le portail de politiques applique une automatisation fondée sur le risque, garantissant une exécution sécurisée, une auditabilité et le respect des normes organisationnelles.
Défis de mise en œuvre et mesures d’atténuation
Aucune capacité opérationnelle transformatrice ne s’implante sans défis. Reconnaître les obstacles potentiels à la mise en œuvre et les adresser par des mesures architecturales et organisationnelles fait partie intégrante d’une solution mature.
La section suivante présente les principaux défis auxquels les organisations peuvent être confrontées lors de l’adoption de l’automatisation AI des bases de données et les mesures d’atténuation prévues :
| Défi | Contexte et atténuation |
| Qualité et exhaustivité de la télémétrie | L’efficacité du système dépend d’abord de la qualité de ses intrants. Les lacunes dans la couverture télémétrique, la granularité des indicateurs ou la configuration de l’espace de travail Log Analytics peuvent conduire à des données incomplètes, ce qui réduit la justesse des recommandations et de la prise de décision. Atténuation : Un module de validation de la santé de la télémétrie surveille en continu la qualité des données, identifie les zones de couverture insuffisante et escalade automatiquement les problèmes de configuration. Le processus de déploiement comprend aussi une phase d’audit de la télémétrie avant l’activation de l’automatisation réelle. |
| Démarrage à froid de la base de connaissances | Un nouveau déploiement commence avec un référentiel de connaissances limité. Il ne peut donc pas immédiatement retrouver des guides éprouvés en l’absence de données internes accumulées et codées. Les recommandations initiales peuvent alors être moins affinées qu’après plusieurs mois d’apprentissage opérationnel. Atténuation : Mise en place préalable d’une base de connaissances construite à partir de schémas d’incidents sectoriels anonymisés. Lors de l’intégration, les incidents spécifiques du client, la documentation opérationnelle et les guides existants sont intégrés pour accélérer la maturité des connaissances et améliorer les recommandations. |
| Confiance accordée au modèle AI et faux positifs | Les scores de similarité dépassant les seuils définis n’offrent pas toujours la garantie qu’un guide recommandé conviendra à un incident nouveau ou encore jamais rencontré. Trop d’autonomie dans ces cas pourrait introduire des risques lors de la correction. Atténuation : Les seuils de confiance peuvent être configurés selon le type d’action et le profil de risque. Si une recommandation est sous le seuil, le système revient automatiquement en mode conseil DBA, où il affiche la meilleure recommandation et son niveau de confiance plutôt que d’agir automatiquement. La validation humaine enrichit alors la base de connaissances et la précision future des recommandations. |
| Définition des frontières de gouvernance | La tolérance à l’autonomie varie grandement d’une organisation à l’autre. Sans politiques de gouvernance claires, l’automatisation excessive peut introduire des risques, alors que des contrôles trop restrictifs limitent la valeur de la solution. Atténuation : Le portail de politiques comprend par défaut une matrice de classification des risques couvrant plus de 40 types d’actions courantes. Cette matrice est validée et personnalisée en collaboration avec les équipes TI du client durant la mise en œuvre, afin que les frontières d’automatisation reflètent la tolérance au risque organisationnelle et les exigences règlementaires. |
| Gestion du changement et adoption par les DBA | Les administrateurs qui ont développé leur expertise en mode manuel peuvent percevoir les systèmes autonomes comme une menace plutôt qu’un levier. Leur réticence à se fier aux recommandations pilotées par l’AI peut ralentir l’adoption, voire entraîner l’apparition de processus parallèles contournant l’automatisation. Atténuation : Le cadre privilégie l’explicabilité. Chaque décision automatisée est accompagnée d’une justification claire, comprenant les incidents historiques extraits, les scores d’efficacité qui ont orienté la recommandation ainsi que le motif ayant permis au portail de politiques d’approuver l’action. Cette transparence positionne le système non pas comme une boîte noire, mais comme un partenaire opérationnel fiable qui démontre comment les décisions sont prises. |
Conclusion : Pourquoi l’auto-guérison est la base idéale pour l’adoption d’Azure SQL
Azure SQL Database offre l’évolutivité, l’élasticité et la souplesse opérationnelle requises pour soutenir les charges de travail modernes en entreprise. Toutefois, pour bénéficier de ces avantages à grande échelle, il faut un modèle opérationnel tout aussi moderne, capable de gérer la complexité, les charges dynamiques et les nouvelles exigences opérationnelles.
La solution d’auto-guérison pilotée par l’AI fournit cette base grâce à un cadre en boucle fermée intégrant une surveillance intelligente, un diagnostic contextuel, une prise de décision appuyée sur la connaissance, une correction automatisée, une analytique prédictive, la gouvernance et l’apprentissage continu. En combinant autonomie opérationnelle et contrôles politiques, la solution permet d’améliorer la disponibilité et la résilience, de réduire la charge opérationnelle, d’optimiser l’utilisation cloud, de renforcer la gouvernance et la conformité, et d’accélérer les initiatives de modernisation.
Plus important encore, la solution transforme la connaissance opérationnelle en atout d’entreprise réutilisable. Chaque incident, action corrective et résultat enrichit en continu la plateforme de connaissances, permettant des recommandations plus précises et des interventions de plus en plus efficaces avec le temps. Ainsi, les opérations passent de l’administration réactive et de la gestion d’incidents à la résilience proactive, prédictive et, ultimement, autonome.
Pour les organisations qui souhaitent moderniser Azure SQL, la solution d’auto-guérison pilotée par l’AI offre une voie concrète vers une exploitation intelligente, transformant les objectifs techniques de fiabilité et d’excellence opérationnelle en véritables capacités d’affaires stratégiques.
Contactez-nous
Pour en savoir plus sur la façon dont HCLTech peut vous aider à adopter l’auto-guérison pilotée par l’AI pour les environnements Azure SQL Database, écrivez-nous à contact-contact.hyc@hcltech.com.

