


Le défi avec le traitement documentaire traditionnel
Les organisations, tous secteurs confondus, partagent le même obstacle : convertir de façon précise, rapide et à grande échelle des documents non structurés et des dossiers documentaires en données exploitables et prêtes à être utilisées par les systèmes.
Prenons l’exemple d’une soumission classique d’indemnisation des accidents du travail en assurance. Un dossier unique arrive sous forme de PDF multi-pages contenant différents types de documents, comme un formulaire ACORD 130, trois années de réclamations, une liste de valeurs assurées et une demande complémentaire. Traiter cela manuellement est coûteux, sujet aux erreurs et lent. Or l’alternative n’a guère permis d’améliorer la situation.
Les solutions TDI traditionnelles reposent sur des bases fragiles
La plupart se basent sur des modèles maintenus par des développeurs qui comportent des règles d’extraction codées en dur pour chaque type de document. Dès qu’un formulaire change de mise en page, le modèle est inutilisable. Lorsqu’un nouveau type de document apparaît, l’ingénierie doit intervenir pour construire une nouvelle chaîne de traitement. Le résultat : une infrastructure qui évolue difficilement, s’adapte lentement et crée une dépendance continue envers les ressources techniques pour répondre à l’évolution des besoins de l’entreprise.
Les solutions enrichies par l’AI n’ont pas complètement réglé le problème
De nombreux produits proposent des modèles d’apprentissage automatique par-dessus les mêmes modèles rigides, par exemple pour améliorer la précision dans les formulaires connus, mais ils requièrent toujours l’intervention des développeurs pour tout ce qui sort du cadre prédéfini. Plus important encore, ces solutions traitent les documents individuellement, ignorent les relations contextuelles entre les documents d’un dossier, n’arrivent pas à valider les données dans leur ensemble et intègrent rarement les résultats dans les systèmes aval comme Guidewire, la souscription, etc.
La faille est structurelle, pas incrémentale
Ce dont les entreprises ont besoin, c’est d’une fondation solide et évolutive offrant :
- Une classification efficace sans formation préalable pour chaque variante de document
- Des capacités de fractionnement contextuel pour séparer les documents fusionnés contenant plusieurs formulaires/ensembles d’information
- Une extraction dynamique, contextuelle et indépendante de la présentation
- Une validation qui fonctionne à l’échelle du dossier, et non seulement du document
- Une intégration native aux systèmes sources sans connecteurs personnalisés
C’est exactement ce que AI-IDP est conçu pour offrir — une approche généralisée et modulaire du traitement intelligent de documents. AI-IDP n’améliore pas le modèle TDI traditionnel ; il l’inverse.
Au lieu de demander « quelles sont les règles pour ce type de document ? », il demande « Que voit l’AI dans ce document et quelles sont les données importantes pour votre entreprise ? »
Ce passage de la rigidité axée sur les règles à une flexibilité pilotée par l’intelligence est la fondation de tout ce que fait AI-IDP.
La plateforme repose sur deux grands principes :
Schéma comme configuration, non comme code :
Un administrateur téléverse un document d’exemple. Peu importe le document, peu importe le secteur. L’AI l’analyse, identifie chaque champ extractible et les présente pour révision. L’administrateur choisit les champs pertinents pour son cas d’usage.
Cette sélection devient un schéma d’extraction réutilisable, stocké et prêt à être déployé.
Aucun code. Aucun modèle. Aucun développeur requis.
L’intégration d’un nouveau type de document se fait l’après-midi même, pas lors d’un sprint. Une nouvelle ligne d’affaires démarre sans billet d’ingénierie. Quand la présentation change, le schéma s’adapte, il ne brise pas.
La configuration remplace la personnalisation. Les utilisateurs d’affaires contrôlent la mise en place. L’ingénierie se concentre sur la valeur ajoutée plutôt que sur la maintenance.
Modules comme capacités, non comme contraintes :
Chaque capacité de traitement aval dans AI-IDP — détection de fraude, triage de souscription, automatisation des réclamations, vérifications de conformité et intégration aux systèmes — est proposée sous forme de module indépendant et enfichable. Les organisations activent seulement ce dont elles ont besoin.
Vous exécutez un processus en santé? L’évaluation des dommages automobiles reste désactivée. Besoin d’une intégration native à Guidewire? Elle s’active en quelques minutes. Expansion vers un nouveau secteur d’affaires? Ajoutez les modules pertinents sans toucher aux chaînes existantes.
Chaque module fonctionne indépendamment, tout en utilisant la même base de données extraite, garantissant ainsi une cohérence sur toute la plateforme sans créer d’interdépendances qui ralentissent l’entreprise.
Vous n’héritez pas d’une plateforme alourdie par des fonctions inutiles. Vous bâtissez précisément l’ensemble de capacités dont votre entreprise a besoin.
Carte des fonctions AI-IDP :
| Fonction | TDI traditionnel | Plateforme généralisée AI-IDP |
| Intégration de type de document | Semaines pour intégrer un nouveau type de document | Minutes : téléversez un exemple, sélectionnez les champs, prêt au traitement |
| Modèles de capture | Modèles maintenus par des développeurs | Configuration admin, aucun code requis |
| Modularité | Pipeline fixe — tout ou rien | Pipeline modulaire — activez seulement ce qui vous est utile |
| Variation des données | Défaillance lors de changements de formulaire | L’AI s’adapte aux variations de présentation |
| Intégrations système | Intégrations personnalisées par cas d’usage | Modules préconstruits activés par configuration |
| Adoption sectorielle | Limité à des secteurs spécifiques | Fonctionne dans l’assurance, la santé, la banque, le juridique, le gouvernement |

Architecture de la solution sur AWS
AI-IDP repose entièrement sur les services serverless d’AWS, permettant une mise à l’échelle automatique de quelques dizaines à plusieurs milliers de documents par jour, sans changements majeurs d’architecture.
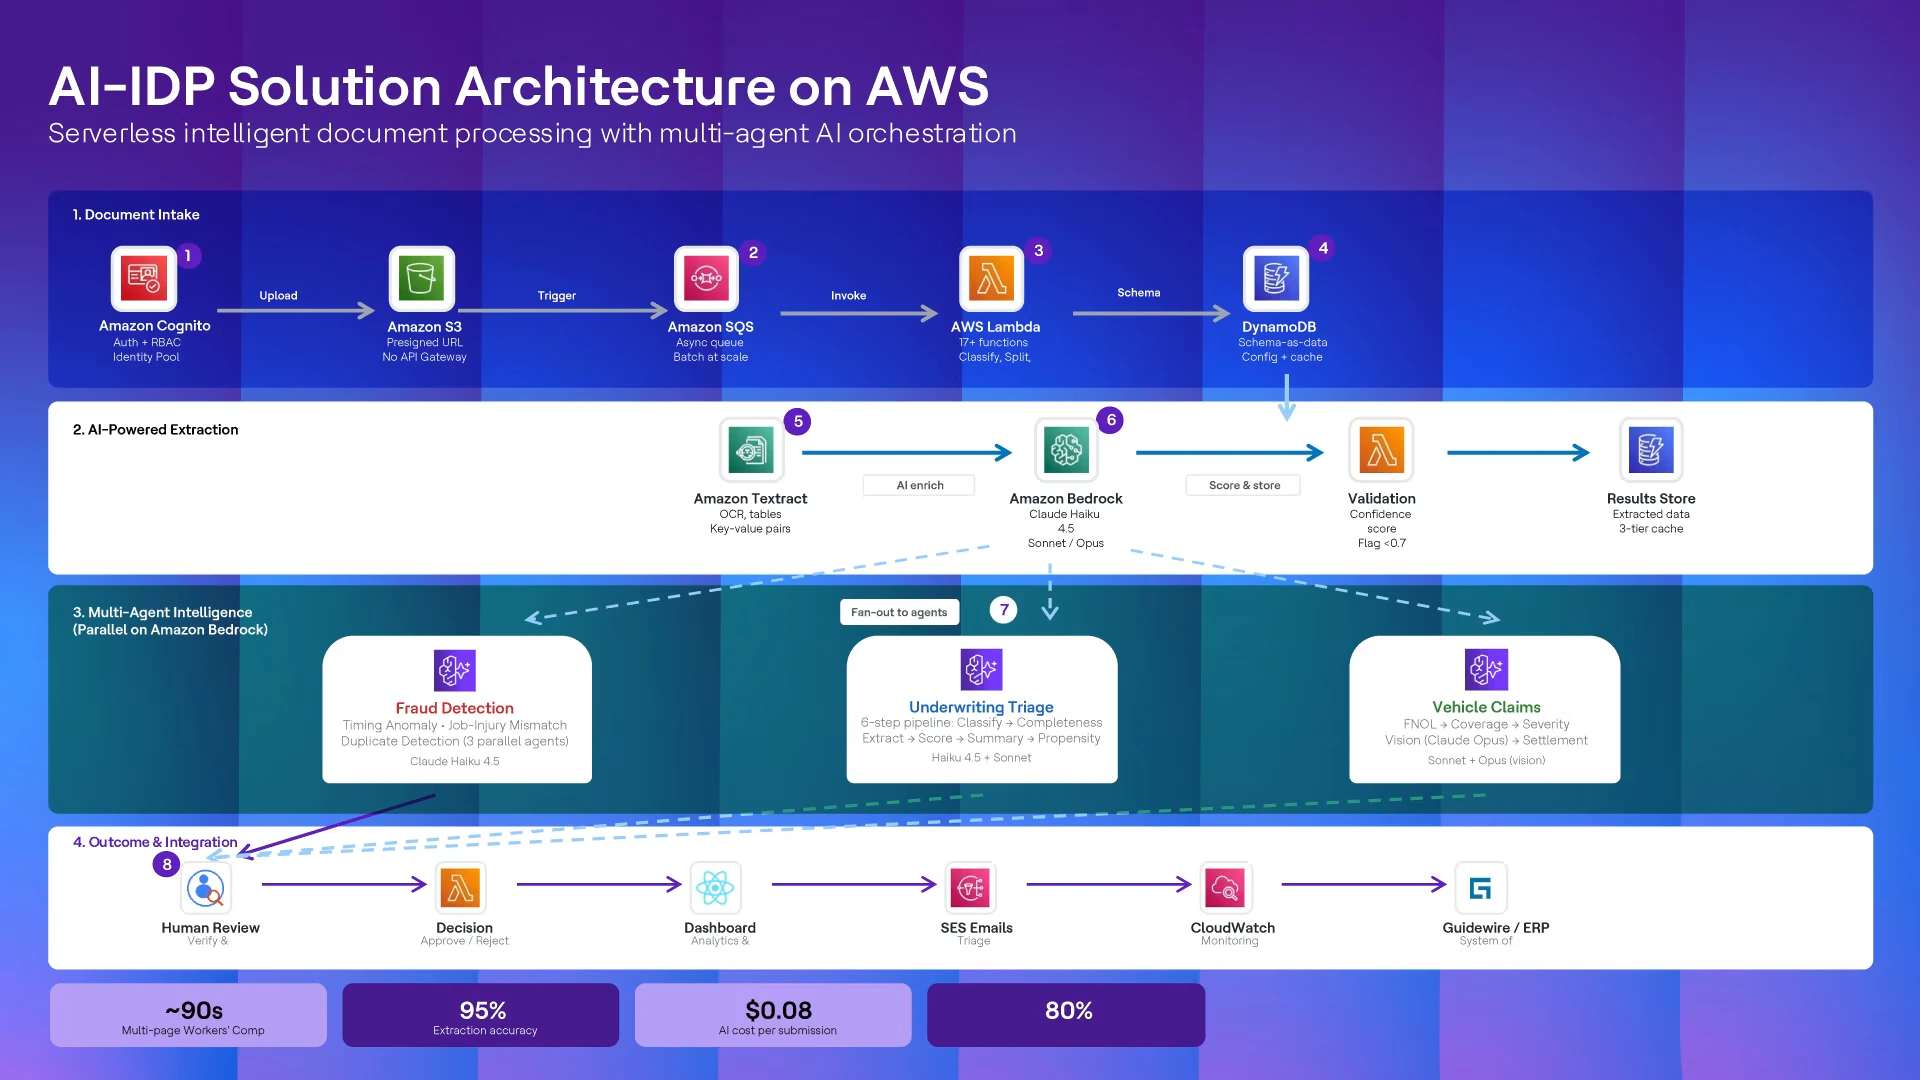
Flux de traitement :
- Saisie de document : Téléversement par glisser-déposer ou ingestion par courriel vers Amazon S3 avec URL présignée pour un transfert sécurisé. Prend en charge les fichiers uniques et les dossiers multi-documents
- Orchestration asynchrone : Amazon SQS dissocie le téléversement du traitement, permettant des opérations en lot sans limitation de débit. Les utilisateurs peuvent téléverser plusieurs documents et continuer à travailler pendant que la file traite à grande échelle
- Classification et fractionnement : Des agents AI analysent les PDF multi-pages, évaluent les transitions de contenu et les limites des formulaires et les séparent en documents individuels. Il s’agit d’une détection intelligente des limites, non d’un comptage de pages basé sur des règles
- Recherche du schéma : Le système récupère le schéma d’extraction configuré pour chaque type de document classifié de DynamoDB. Seuls les champs sélectionnés par les administrateurs lors de la configuration sont ciblés
- Agent d’extraction : Amazon Textract/l’agent d’extraction effectue l’OCR, l’extraction des paires clé-valeur et des tableaux. Les entités sont structurées, notées en fonction de leur niveau de confiance et stockées. Les champs à faible confiance sont automatiquement signalés pour révision humaine
- Traitement agentique : Amazon Bedrock gère l’orchestration multi-agent. Selon le dossier et le cas d’utilisation dans le contexte, les agents appropriés sont invoqués, par exemple :
- Détection de fraude ; trois agents spécialisés fonctionnent indépendamment : un agent d’anomalie temporelle analyse les motifs de dates révélant une préméditation, un agent d’inadéquation emploi-blessure recoupe les codes de métier avec les blessures rapportées et un agent de détection des doublons scanne l’historique du demandeur auprès des assureurs
- Triage de souscription : un algorithme de pondération tient compte de l’exhaustivité des données, de la qualité des concordances tierces, de l’alignement du code de catégorie et de l’historique des sinistres pour acheminer les soumissions dans des files prioritaires
- Participation humaine : Les utilisateurs révisent les valeurs extraites avec surbrillance de la zone sur le document source. Toutes les modifications humaines sont revues et conservées. L’assistant AI répond en temps réel aux questions sur les données extraites
- Intégration : Les données extraites, les scores et les résumés s’affichent sur le tableau de bord frontal et sont transmis aux systèmes sources connectés avec toutes les métadonnées, la classification et les résumés générés par l’AI
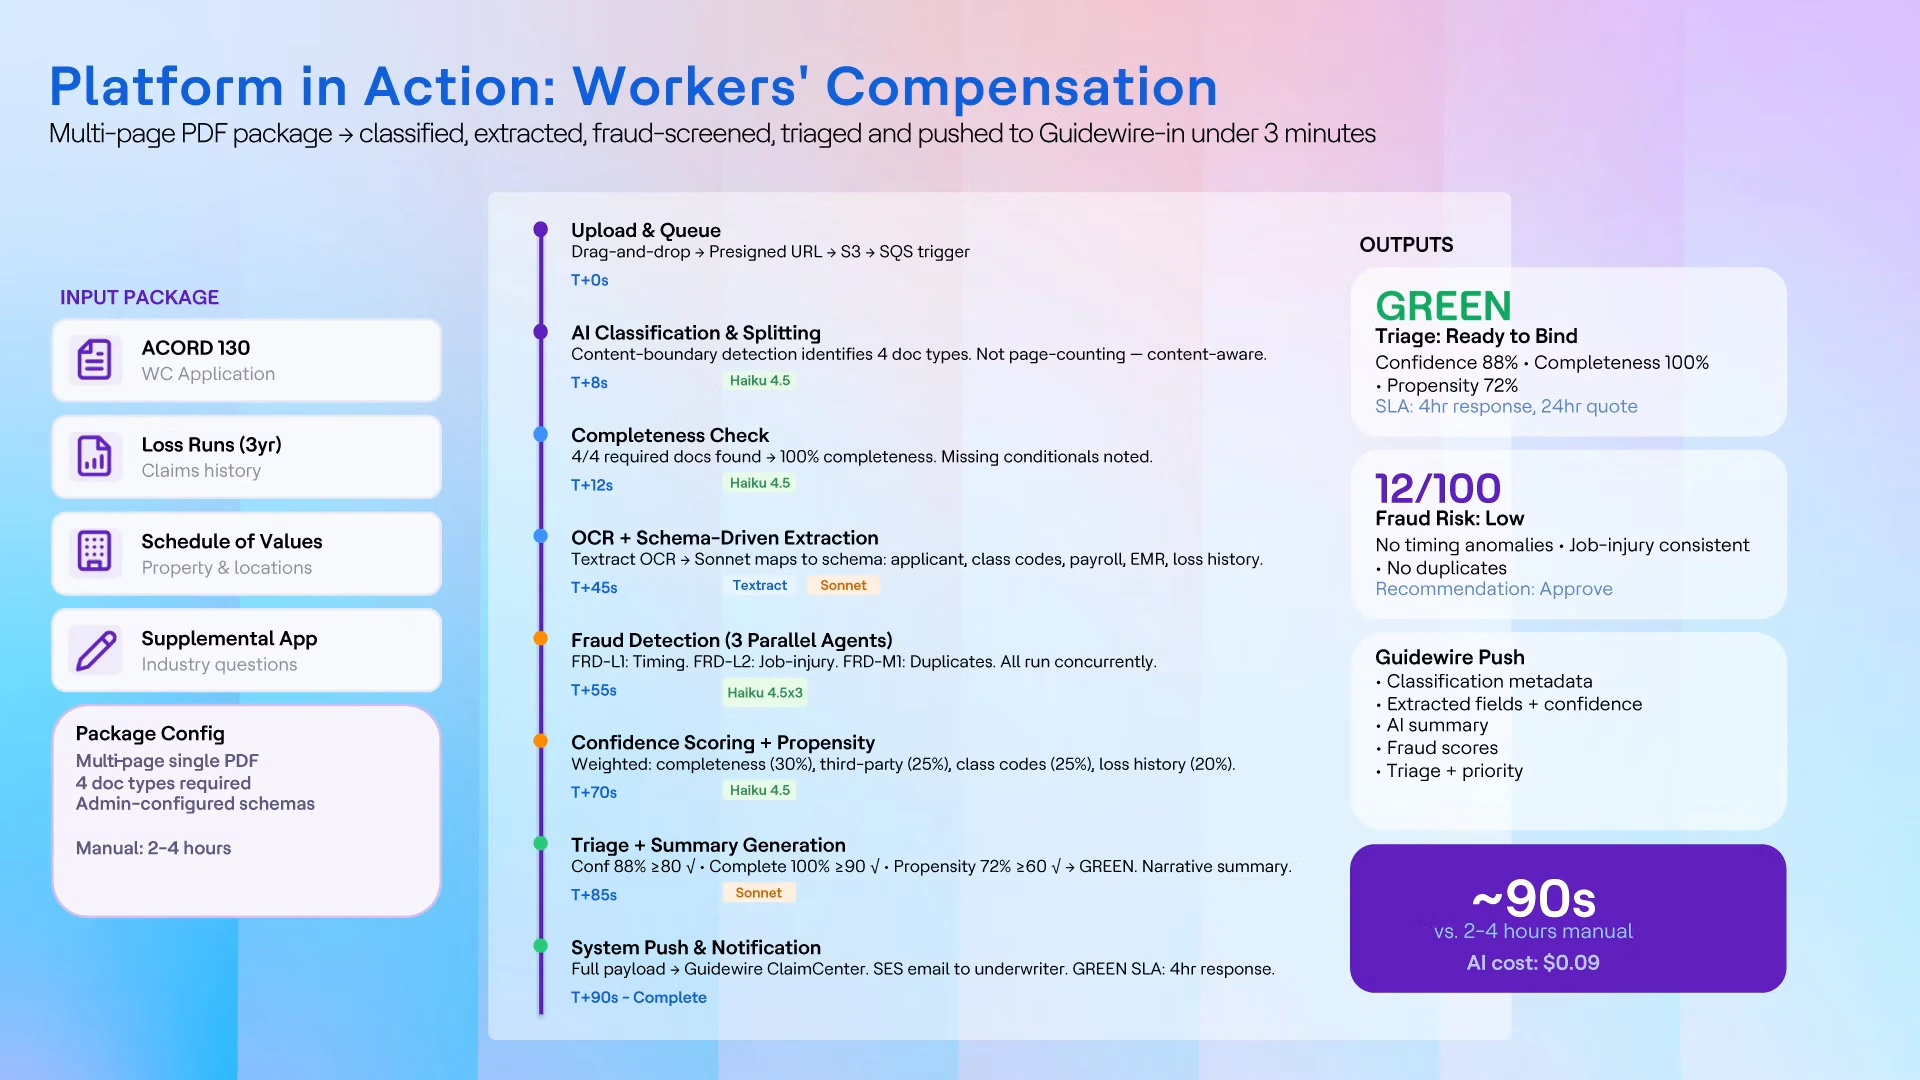
Plateforme en action : Cas d’utilisation – indemnisation des accidents du travail
Pour illustrer la plateforme concrètement, prenons une implantation réelle pour un processus d’accueil d’indemnisation des accidents du travail.
Conclusion
AI-IDP représente un passage du traitement documentaire traditionnel rigide, centré sur les modèles, vers une plateforme généralisée où les administrateurs configurent les schémas d’extraction et où les capacités de traitement sont activées sous forme de modules. La même infrastructure serverless sur AWS gère les soumissions d’assurance, les dossiers de santé, les demandes de prêt et les permis gouvernementaux, distingués uniquement par la configuration.
Les organisations souhaitant moderniser le traitement des documents dans plusieurs secteurs d’activité peuvent s’appuyer sur cette approche pour réduire les coûts d’exploitation, accélérer les délais de traitement et éliminer le goulot d’étranglement d’ingénierie créé par les solutions TDI traditionnelles.
Services AWS utilisés :
Construit sur AWS : Lambda, Amazon Textract, Amazon Bedrock (Claude 3), DynamoDB, S3, SQS, Cognito. Intégré à Guidewire ClaimCenter.

